

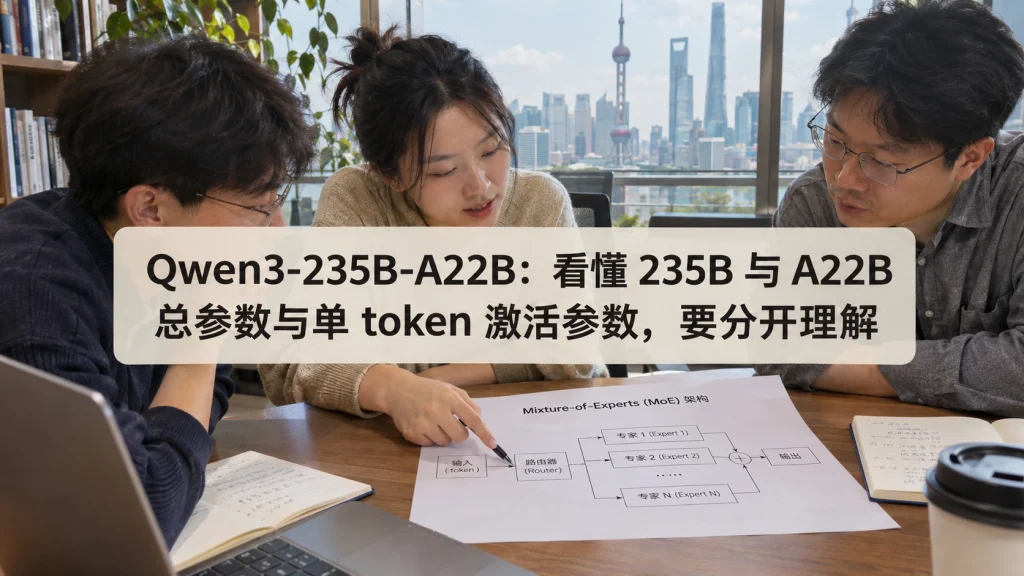
Qwen3-235B-A22B 是 Qwen3 系列中最值得被单独拆解的一款开源大模型。它采用混合专家(MoE,Mixture of Experts)架构,这种设计意味着模型并非所有参数都在每次推理时全部参与计算,而是会根据输入动态激活部分参数,在保证大模型容量的同时还可以降低单次推理的计算开销。该模型也提供了可自由获取的开源权重,支持开发者根据自身需求进行部署、微调与二次开发,适配各类本地化业务场景的落地需求。对搜索 Qwen3-235B-A22B、Qwen3 参数或开源大模型的读者而言,这一篇文章可以帮助你进行了解。
Qwen3-235B-A22B 是什么
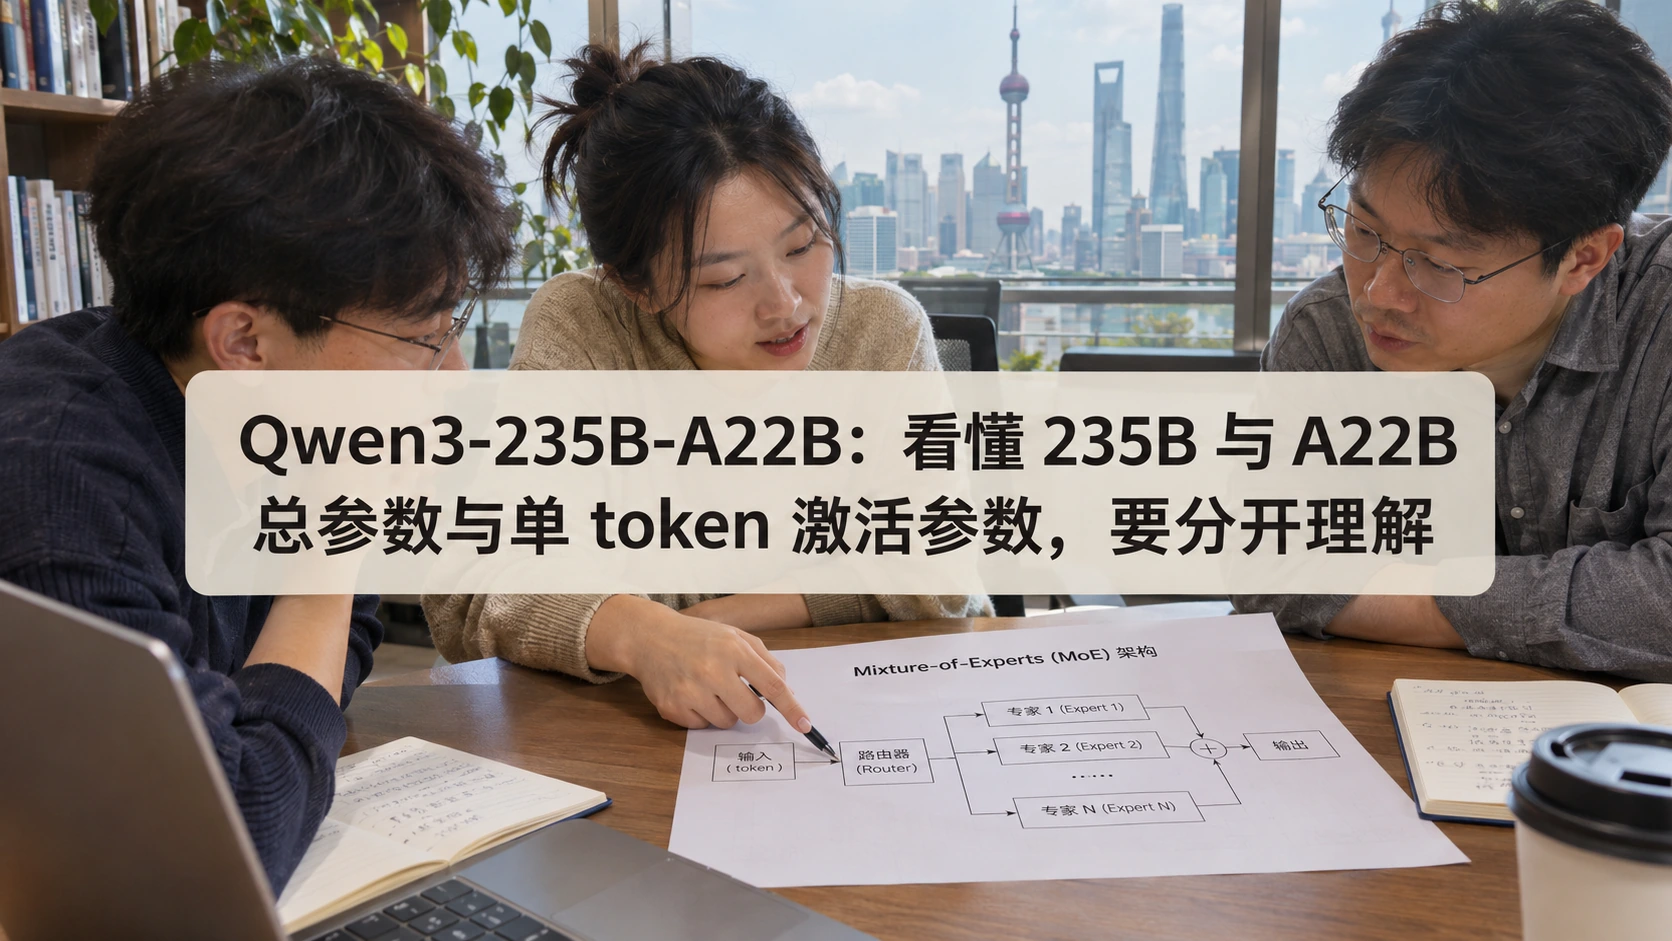
在 Qwen 官方发布文章 《Qwen3 Think Deeper Act Faster》文档说明中,Qwen3-235B-A22B 被描述为Qwen3系列的重量级开源模型。是一个带有明确架构标识的模型版本,它不是单纯把一个稠密模型堆到 235B,而是用 MoE 架构把“总参数规模”和“单次推理激活参数”分开。
它可以用于研究、私有化验证或通过兼容入口来接入相关的应用,但“能否直接上线使用”还要看权重来源、推理框架、上下文设置、模型版本和业务验收标准。把发布信息、模型能力和服务可用性分开来写,才不会把历史错误当成当前 API 规则。
235B 与 A22B 分别代表什么
Qwen 官方模型卡 《Qwen Qwen3-235B-A22B》 给出的模型概览显示,235B代表该模型的总参数量约为2350亿,B对应十亿级别的参数计量单位,这一数值体现了模型的整体参数规模,决定了模型的知识储备与潜在能力上限;A22B中的A是Activate(激活)的缩写,代表该模型在单次推理过程中实际参与计算的激活参数量约为220亿,也就是每次处理用户输入时,只会调用约十分之一的总参数完成计算。在MoE架构下,这两个参数是理解模型特性的核心,总参数量决定了模型的知识容量上限,而激活参数量则直接决定了单次推理的计算开销、响应速度与部署成本,二者的分离设计正是该模型兼顾能力与效率的关键所在。
思考模式与非思考模式怎么区分
Qwen 官方技术文档 《Qwen3 Concepts》 说明 Qwen3 的混合思考设计可在不更换模型的情况下切换思考与非思考,并还解释了模型命名中 Instruct、Thinking、Base 与无后缀版本的差异问题。
对 Qwen3-235B-A22B 而言,思考模式适合复杂逻辑、数学、代码和需要多步推导的任务场景;非思考模式更适合高频问答、改写、摘要和有明确格式要求的常规任务场景。这里的区分关键不是谁把思考更好就越牛,而是要根据任务的错误代价、响应时间和预算设定。简单任务强行拉长推理,未必能带来好的结果。
还要注意版本边界。官方技术文档也已经把 Qwen3 的不同日期后缀和 Instruct、Thinking 类型列为不同标识;写部署方案、测试记录时,要完整记录模型名称、发布日期或版本后缀、是否开启思考、上下文长度和所用框架,避免将不同版本的结果混在一起进行比较。
部署与权重理解不能只看参数
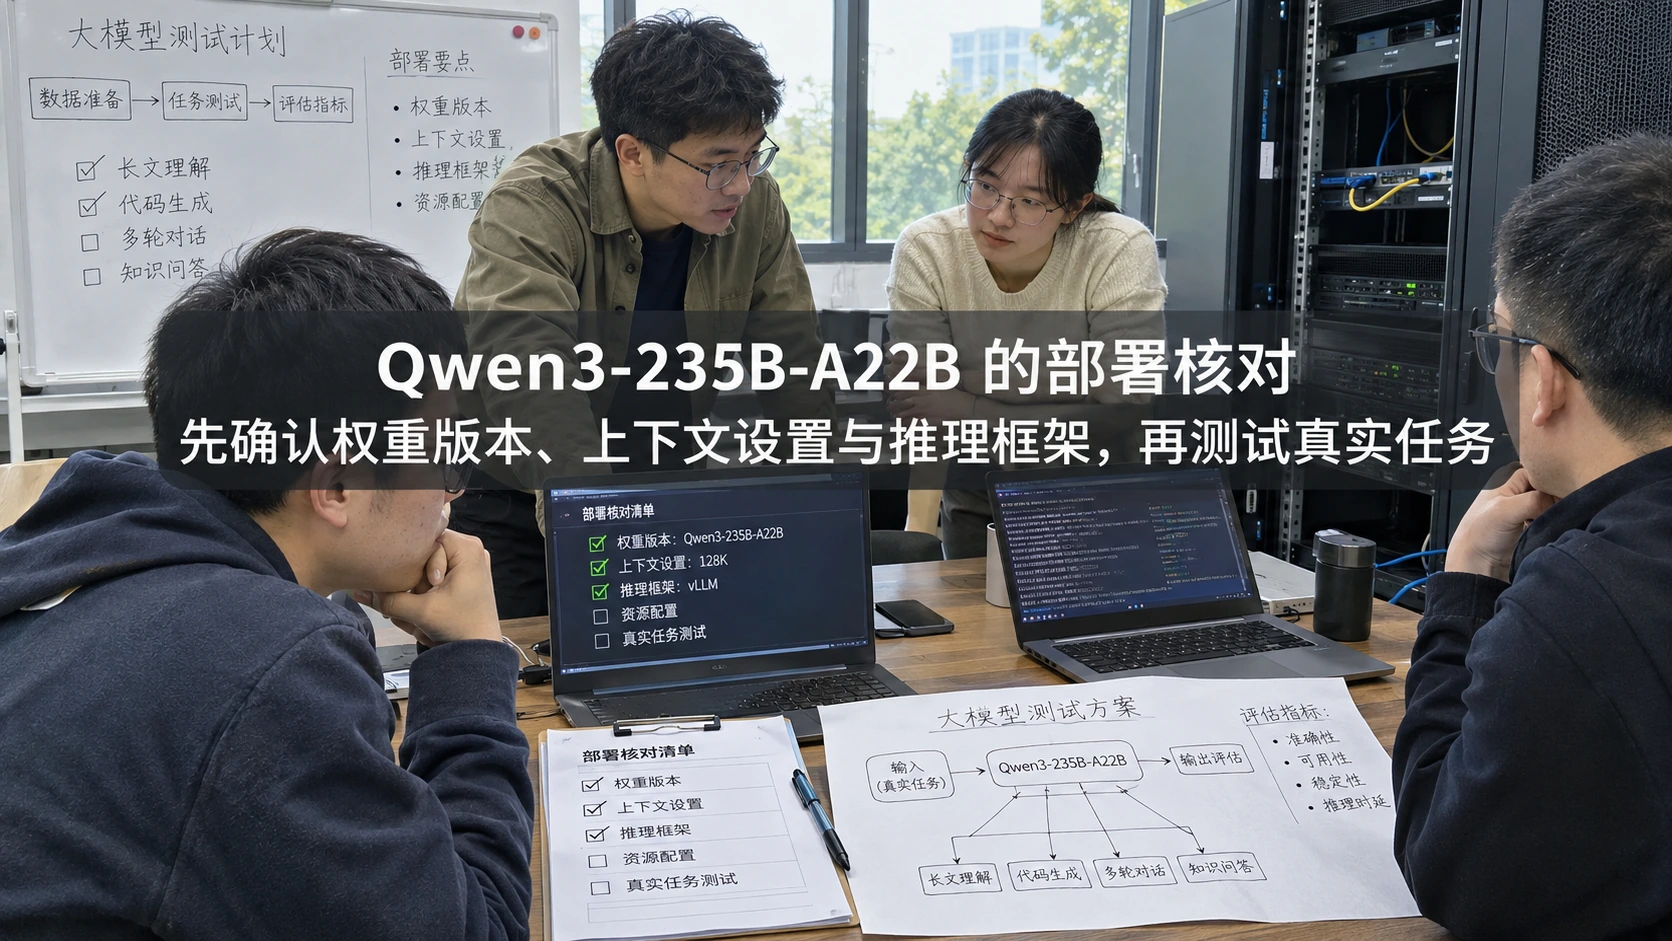
Qwen 官方快速开始文档 《Qwen3 Quickstart》 提供了 Transformers、vLLM 与 SGLang 等推理示例,并对 Qwen3-2507 系列的 Instruct 和 Thinking 使用方式作了区分,所以在部署的时候更不能只看参数。
部署前要核对四项:第一,下载或调用的完整模型标识;第二,权重格式、量化类型与许可证;第三,推理框架和版本是否支持该模型的架构及思考输出;第四,目标上下文长度与并发是否和硬件资源互相匹配。把这些条件写入部署记录,出现输出差异时才能判断是模型更新、框架配置还是任务本身造成的影响。
如果团队采用的是托管接口,也还是要把模型本体与服务层配置进行分开记录。相同的 Qwen3-235B-A22B 名称可能出现在不同平台、地区或接口版本中,默认的最大输出、限流、工具调用方式、价格和可用上下文可能不会一样。实际接入前,可先用一小组固定请求保存原始输入、响应时间和错误码,再据此设置超时、重试和人工回退策略。这样后续即使更换了新供应商或升级新框架,也能保留之前的数据。
Qwen3-235B-A22B 怎么做实际的选型
1,先建立一组脱敏真实任务
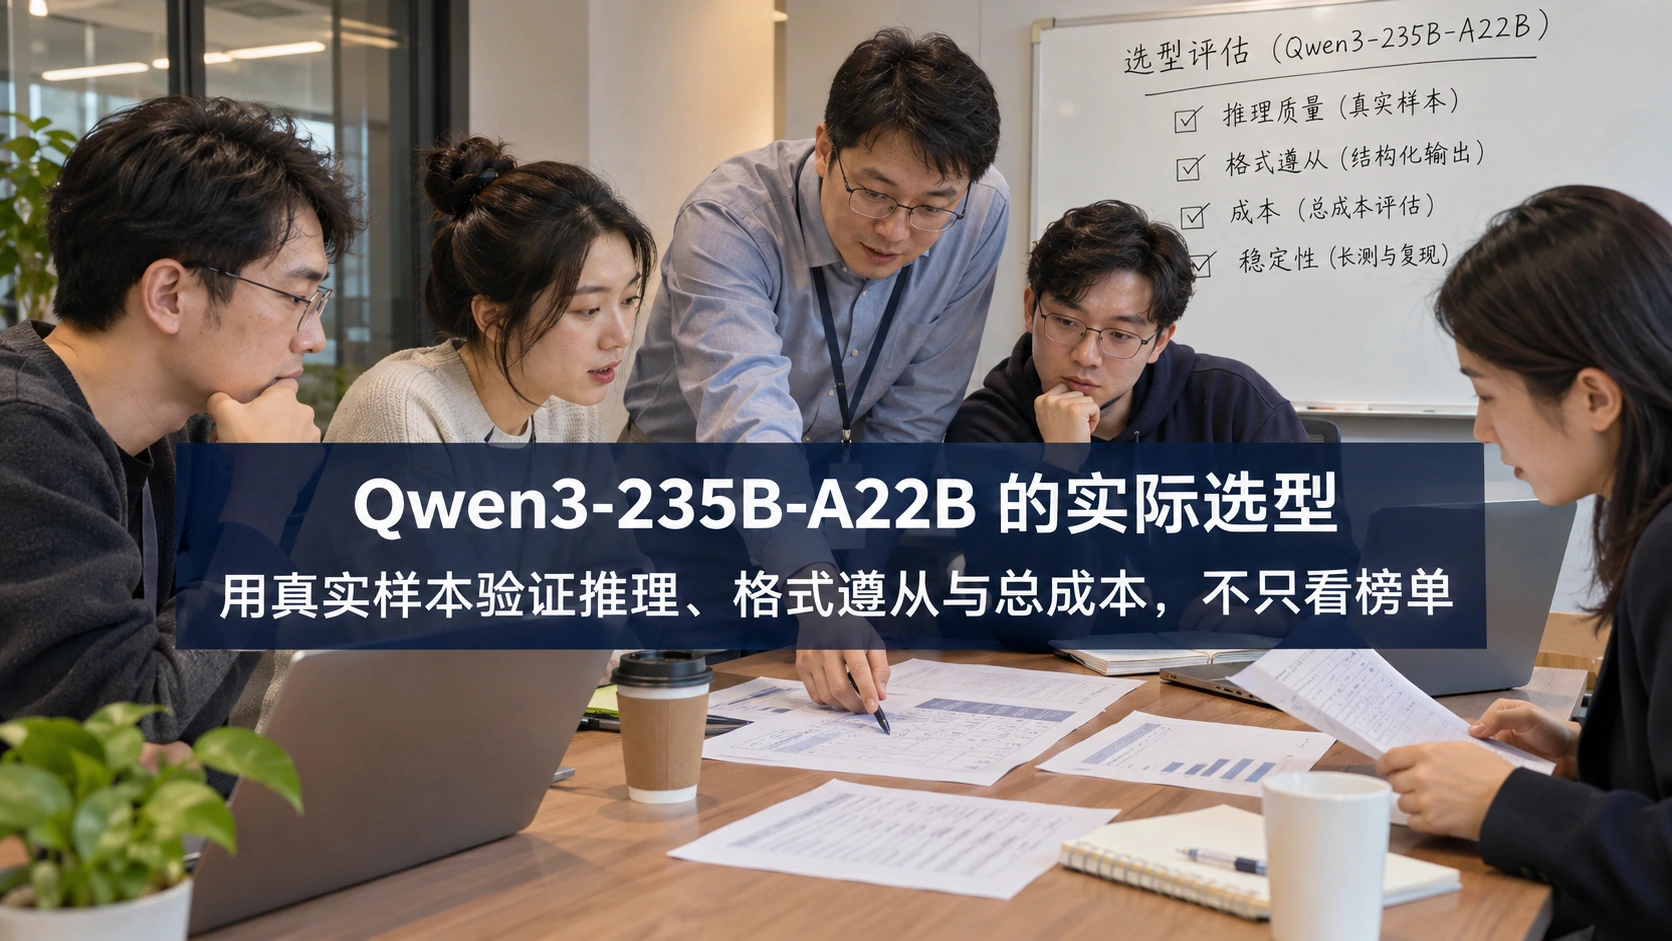
先准备 20 到 30 条来自真实流程的脱敏样本,覆盖最常见和最容易出错的场景。例如,内容团队资料归纳和固定字段的输出;研发团队的代码解释、单元测试生成和变更说明;运营团队的多轮问答、分类和表格结构。每一类任务都要提前写清楚可复核的标准是什么,而不是只凭感觉打分。
2,将质量 稳定性与成本放在同一张表
除了脱敏真实任务外,还要记录格式遵从率、事实核验通过率、重试次数、平均响应时间、人工修改时间以及单任务总成本。对于需要合规审核或可追溯内容的流程,稳定输出是最重要的。选型结论应来自固定条件下的多轮结果,而不是单条演示或一个公开榜单。
评测信息应该怎么读
官方发布页和模型卡中的评测信息可以帮助了解 Qwen3-235B-A22B 的能力方向,但不能直接采用。阅读信息时,要同时确认所用版本、提示设置、是否启用思考、上下文长度、是否允许工具调用和评测日期。一个在代码或数学基准中表现突出的模型,不适合企业知识库、固定格式抽取或高风险内容生产,但是在逻辑任务推理是十分的适合。
常见问题
Qwen3-235B-A22B 与 Qwen3-235B-A22B-Instruct-2507 是同一个版本吗?不是。它们名称中的类型和日期后缀不同,引用资料、复现实验和部署时都应使用完整模型标识。
22B 激活参数是否等于本地运行只需按 22B 准备资源?不能这样判断。激活参数反映 MoE 单 token 的参与计算规模,而本地加载和运行还与权重文件、量化、并行和缓存策略有关。
模型输出可以直接发布吗?不建议。涉及事实、代码、安全、法律、金融、医疗或用户数据的内容,仍应经过来源核验、测试和人工审核。
结语
Qwen3-235B-A22B 的价值不只在于 235B 这个数字,而在于它提供了一个可从参数命名、MoE 路由、思考模式、版本边界到部署验证逐层分析的具体模型案例。先看懂官方文档,再用真实任务比较输出、稳定性和总成本,这样才能把模型参数转化为可验证的技术决策。
官方资料来源
- Qwen 官方发布页:Qwen3 Think Deeper Act Faster:https://qwenlm.github.io/blog/qwen3/
- Qwen 官方模型卡:Qwen Qwen3-235B-A22B:https://huggingface.co/Qwen/Qwen3-235B-A22B
- Qwen 官方技术文档:Qwen3 Concepts:https://github.com/QwenLM/Qwen3/blob/main/docs/source/getting_started/concepts.md
- Qwen 官方快速开始文档:Qwen3 Quickstart:https://github.com/QwenLM/Qwen3/blob/main/docs/source/getting_started/quickstart.md
会员留言