

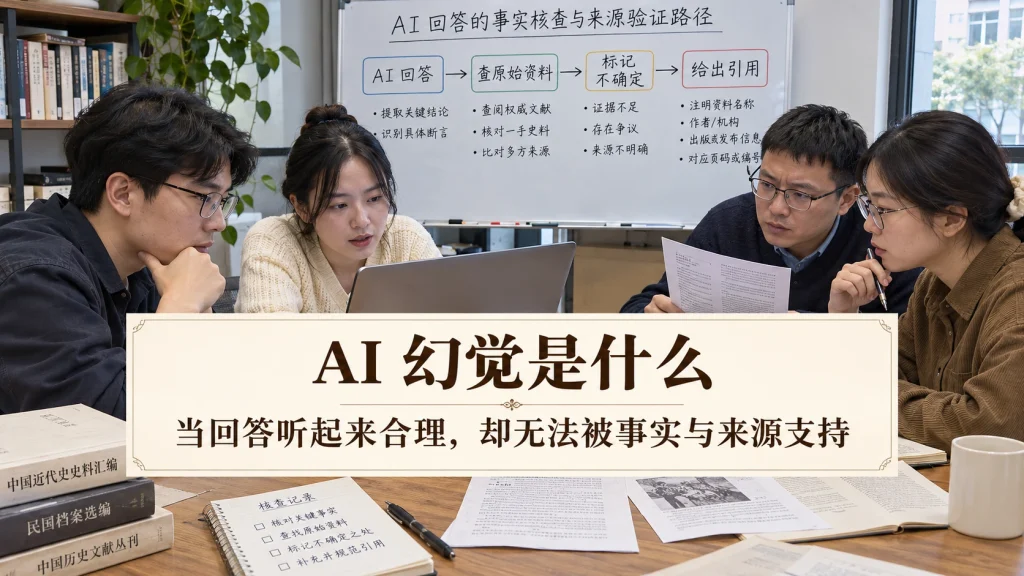
AI 幻觉意思是大语言模型给出的结果看起来连贯、甚至语气非常肯定,但没有事实、原始资料或提供上下文佐证的内容。它可能表现为编造人物经历、论文和链接,也可能是把正确概念放进错误时间、把不完整资料推成确定结论。对于搜索 AI 幻觉是什么、大模型幻觉、AI 编造内容或如何减少 AI 幻觉的读者,本文将述说大模型为什么会编造内容与如何降低风险。
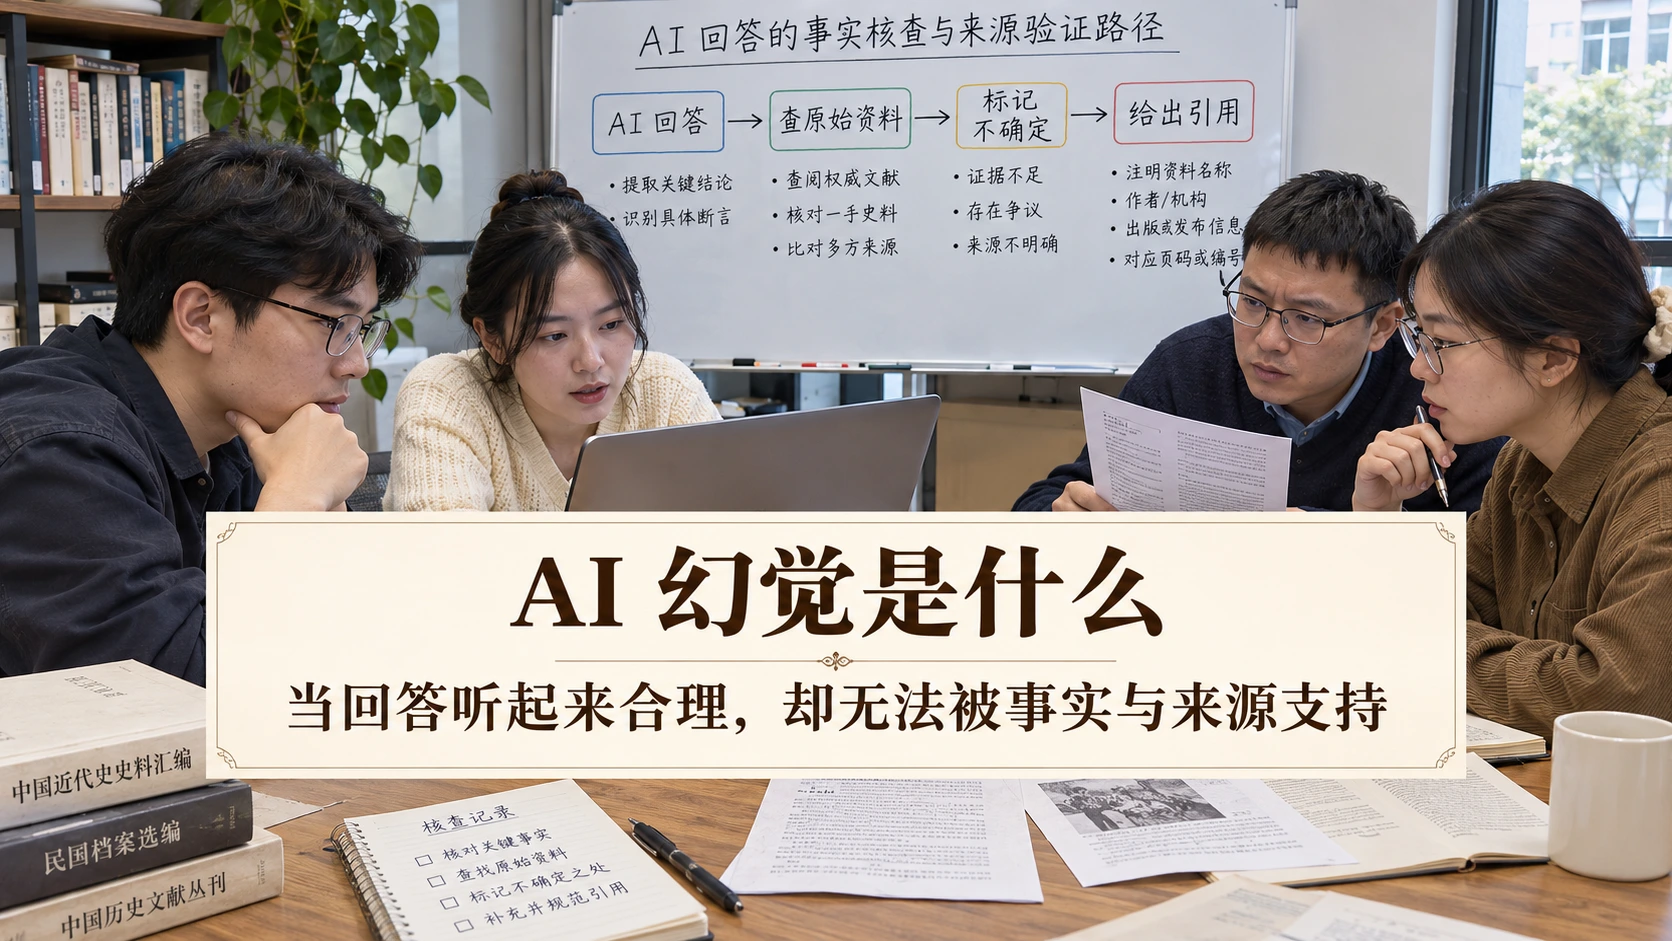
AI 幻觉是什么
OpenAI 官方文章 《Why language models hallucinate》 将 hallucinations 描述为语言模型自信生成但不真实的内容,并指出这种错误可以发生在看似直接的问题上。
这里的“幻觉”是技术领域对输出错误的一种命名,不表示模型具有人的感知和意识。它的关键特征是:回答的结果具有合理的语言结构,却缺少可靠依据。例如模型可能为一本并不存在的书写出作者、出版社和摘要;也可能把多份资料里的片段拼成一条从未发生过的事件。让看上去流畅、细节丰富的答案,但是不同于可信答案。
AI 幻觉与普通笔误含义也不同。笔误可能是一个字、数字或格式写错;幻觉常见于模型为了形成完整回答而补足缺失信息。也不是故意误导:模型没有主观意图,但系统设计者和使用者要对它在哪里使用、是否核查进行负责。
大模型为什么会产生幻觉
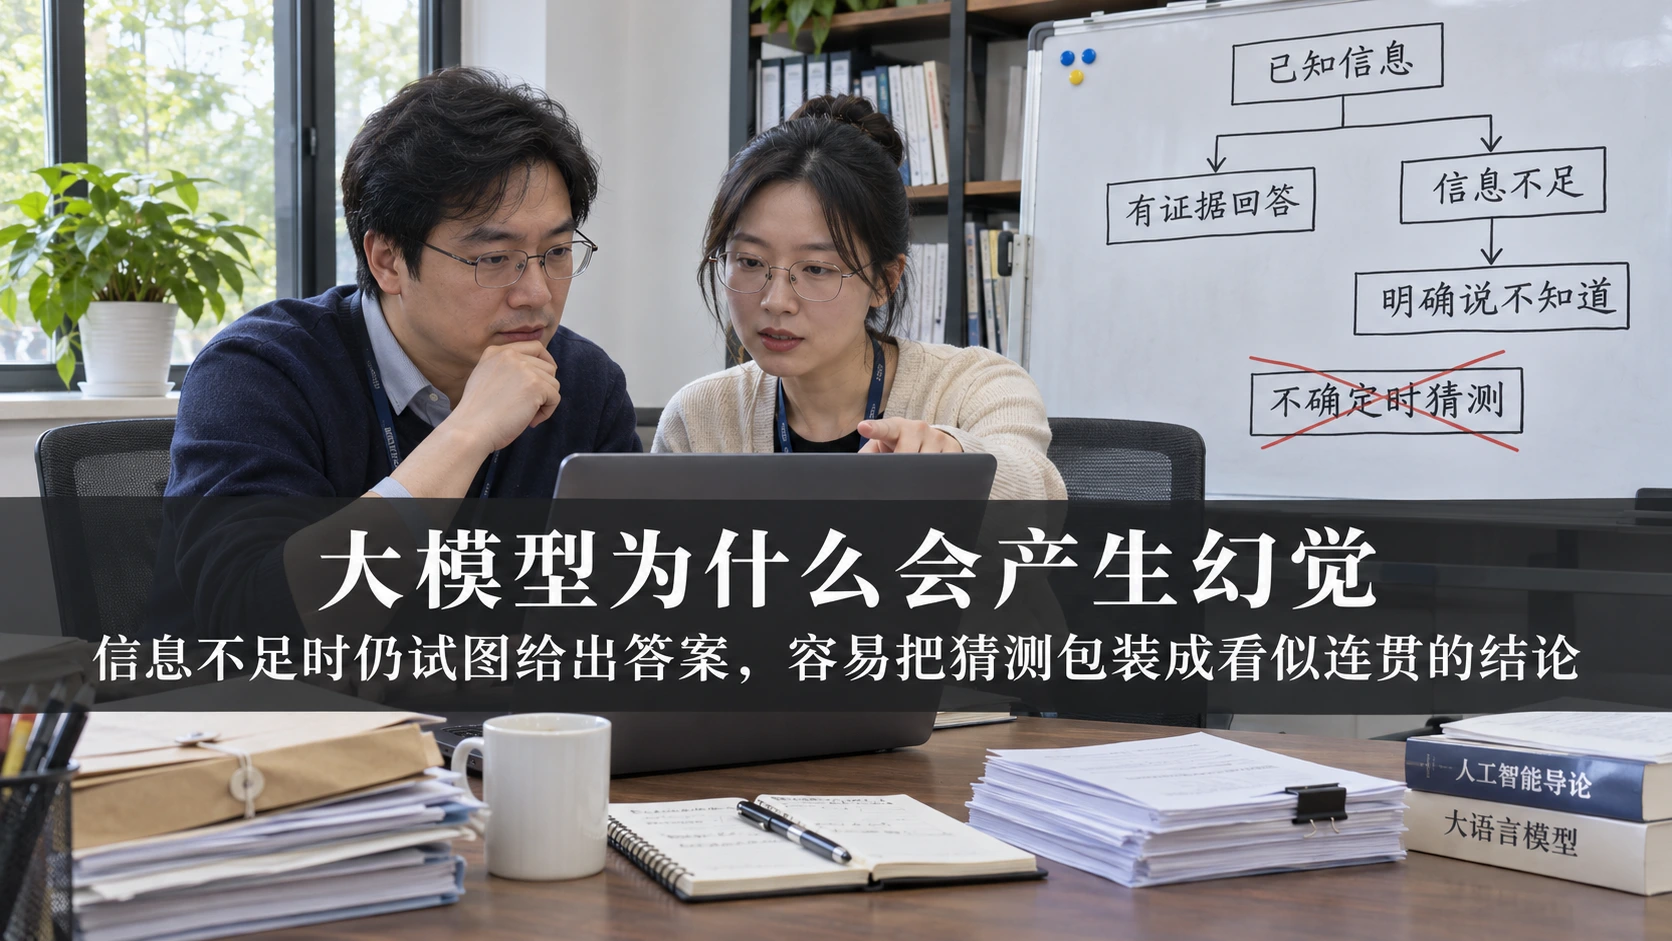
OpenAI 官方文章 《Why language models hallucinate》 分析认为,常见训练与评测方式会鼓励模型在不确定时猜测,而不是承认不确定;若只按答对率排名,拒答可能得零分,猜测却仍可能碰巧正确。
大语言模型的基本任务是根据已有上下文预测下一个最可能的词,而不是在内部保存一张随时可查验的事实表。当问题涉及罕见人物、最新事件、精确日期或训练资料未覆盖的领域时,模型仍会倾向于组织一个形式结构完整的回答。于是“语言上像真的”与“事实是真的”可能意思就会分离。
信息不足的时候,流畅表达会掩盖信息不确定性
Anthropic 官方研究文章 《Tracing the thoughts of a large language model》 讨论了模型在未知实体或信息不足时拒绝推测的机制,并展示当这种约束没有发挥作用时,模型可能生成看似合理但不真实的说法。
因此,要求模型“必须给出答案”往往会放大幻觉风险。更好的规则不是把拒答视为失败,而是要求模型在证据不足时明确说明未知、提出需要补充的资料,或只给出已被来源支持的部分。对用户而言,越是要求精确姓名、数字、出处、法规条款和时间点,越应把模型的输出结果视为待核实草稿。
AI 幻觉最常见的四种表现
第一类是编造来源:虚构论文标题、网页链接、作者或引文。第二类是事实拼接:把不同人物、不同时间或不同版本资料拼成一件事。第三类是错误推断:来源只支持“可能”,回答却写成“已经证实等确定推论”。第四类是过度确定:面对资料不足的问题,模型没有说明边界,反而给出完整步骤、精确数值或肯定判断。
这要求我们在识别时不要只搜一句答案是否完全一样就可以了,而要把结论拆成可验证的声明:谁、在何时、做了什么、依据是什么、范围有多大。只要其中一个关键环节找不到可靠来源,就不应把整段回复直接用于发布、决策或对外沟通来使用。
怎样判断一段回答是否存在幻觉
Microsoft 官方文档 《Retrieval-Augmented Generation Evaluators for Generative AI》 说明 Groundedness 是用于衡量生成回答是否与给定上下文一致、是否包含未被上下文支撑的内容;文档也区分回答相关性、完整性与检索质量。
最实用的检查不是问“这段话像不像人写的”,而是问它是否有依据。若系统提供了上下文或知识库,可逐条比对:回答中的关键结论是否能在来源中找到;数字、日期和专有名词是否一致;引用是否真正支撑紧邻的结论而不是大概推论;回答有没有超出资料范围的补充。Groundedness 关注的是回答有没有扎根于给定内容,不能单独替代真实性、时效性和人工权限检查。
给模型设计可核对的输出格式
在团队场景中,可以要求模型把“事实结论”“来源位置”“不确定项”分开输出。对于每个高风险结论,至少保留原始链接、文档版本或章节位置;当系统没有足够上下文时,输出“资料未覆盖”比补写一个貌似有用的答案更可靠。
如何降低 AI 幻觉风险的做法
Anthropic 官方文档 《Prompting best practices》 说明给出,在没有阅读相关文件前不要推测;先调查、读取相关材料,再基于已打开的内容来回答。
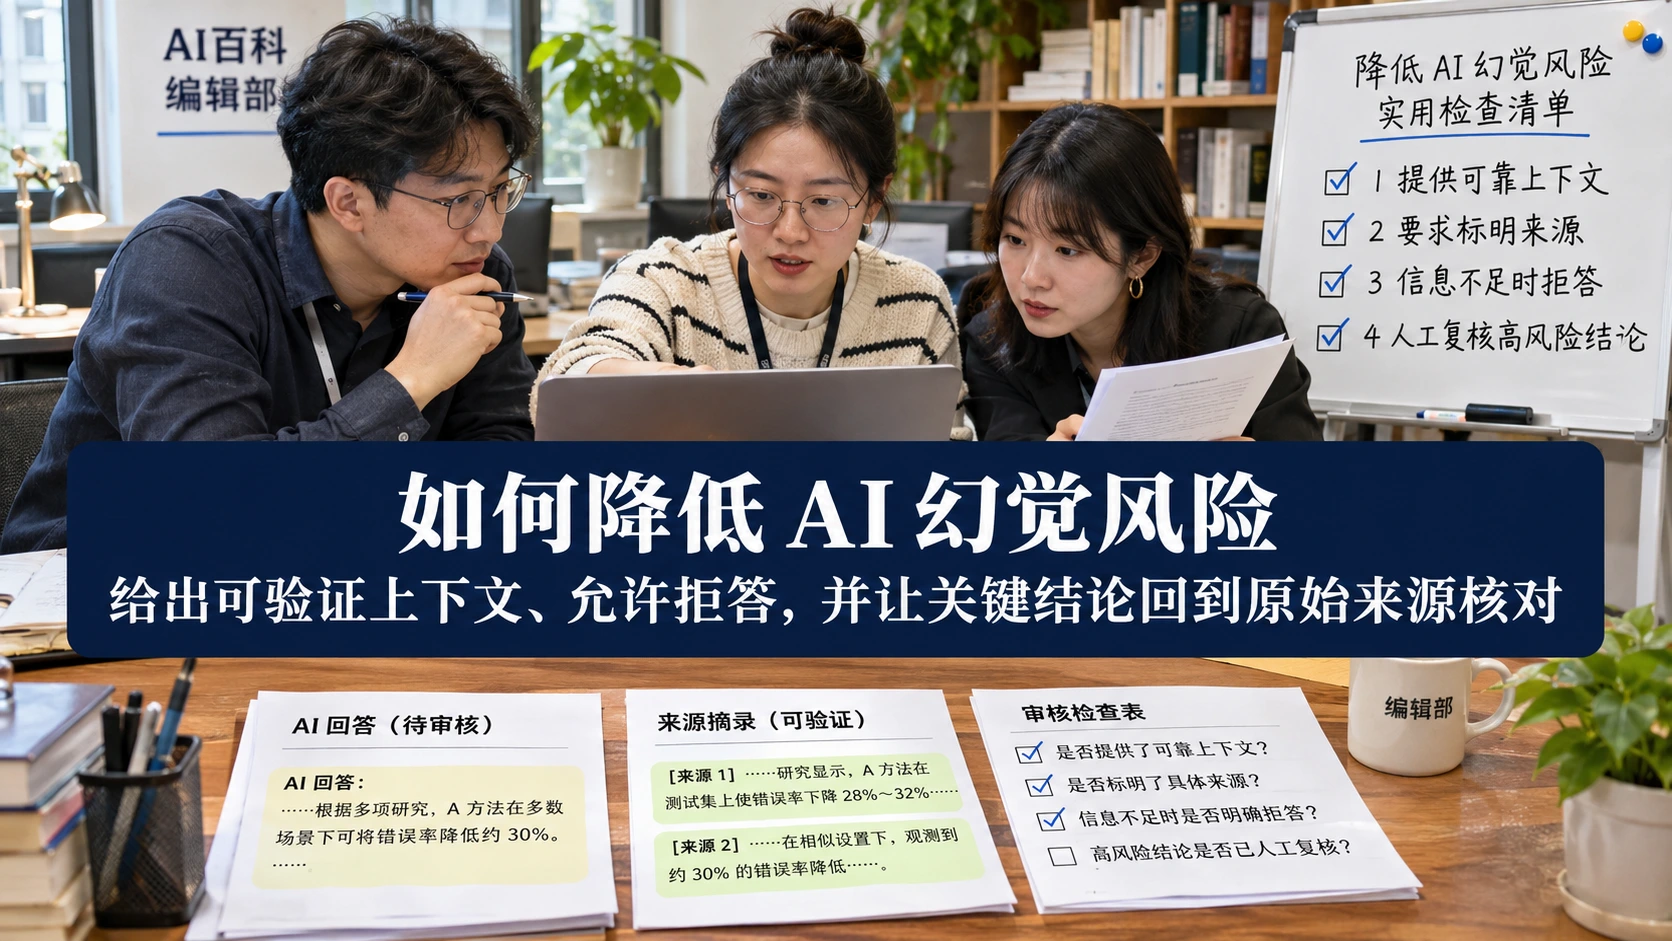
第一,提供可靠且足够的上下文。对于企业制度、产品文档或项目代码,让模型读取当前版本的原始内容,再限定它只能根据这些内容回答。第二,允许拒答。提示词和产品界面应明确:资料不足时可以说不知道、可以要求补充信息,不能为了完整而猜测。第三,要求显示引用或证据位置,并让用户能打开原文复核。
第四,给高风险任务增加人工复核。医疗、法律、财务、招聘、合规和对外公告等内容,即使模型给出了来源,也需要具备相应职责的人确认。第五,持续做评测:收集真实问题,标出可靠答案和来源,分别记录模型是否召回正确资料、是否遗漏限定条件、是否在无答案时拒答。降低幻觉不是一次性调一个提示词,而是内容、模型、检索和流程共同相互作用。
RAG 能解决 AI 幻觉吗
RAG 可以降低一部分由知识缺失、资料过期带来的风险:它会先检索相关内容,再把内容作为上下文交给模型。但 RAG 不等于自动正确。若知识库里是旧版本、检索到的片段不相关、权限过滤失效,或者模型超出提供资料自由发挥的时候,还是会出现幻觉。RAG 的价值在于让回答更容易回到来源复核,而不是为答案盖上“绝对真实”的印章。对想要RAG的读者可以去看RAG是什么这篇文章,可以帮助你理解RAG。
常见问题
AI 幻觉会完全消失吗?目前不能保证。模型能力、上下文、拒答策略和评测都能降低发生率,但事实错误与不当推断仍需要防护和人工核查。
有引用就一定没有幻觉吗?不一定。引用可能过期、被误读,或与结论并不对应。应核对引用是否直接支持关键主张。
普通用户怎么避免被误导?对涉及金额、健康、安全、法律义务和重要人物履历等内容,优先查看一手来源;把模型当作整理线索的助手,不当作最终事实来源。
结语
理解 AI 幻觉的关键,是区分“表达得很像答案”与“答案被证据支持”。大语言模型能高效整理、改写和解释信息,但也会在缺少资料时给出出连贯的错误内容。让模型根据可核对的上下文回答、允许它承认不确定、展示来源并把高风险结论并交给人工复核,才是把 AI 用得更可靠的方式。
官方资料来源
- OpenAI 官方文章:Why language models hallucinate:https://openai.com/index/why-language-models-hallucinate/
- Anthropic 官方研究文章:Tracing the thoughts of a large language model:https://www.anthropic.com/research/tracing-thoughts-language-model
- Microsoft 官方文档:Retrieval-Augmented Generation Evaluators for Generative AI:https://learn.microsoft.com/en-us/azure/foundry/concepts/evaluation-evaluators/rag-evaluators
- Anthropic 官方文档:Prompting best practices:https://docs.anthropic.com/en/docs/build-with-claude/prompt-engineering/prompt-templates-and-variables
会员留言