

在选择 RTX 5090 云主机来进行部署的时,最容易混淆的是“显卡型号”和“可直接下单的实例”。前者是硬件规格,后者还包含 CPU、内存、存储、镜像、驱动、网络与交付方式。因此,在选择矩池云 RTX 5090 32GB 云主机是否适合自己得任务来进行部署时,不能只看 32GB 显存这个一个指标,还要看这套配置能否承载目标模型的推理、并发、数据读写和日常运维。本文从硬件基础、可部署模型、运行时预算、租用核对事项和常见问题几个方面,说明这台实例的实际适用范围。
矩池云 RTX 5090 32GB 云主机是什么
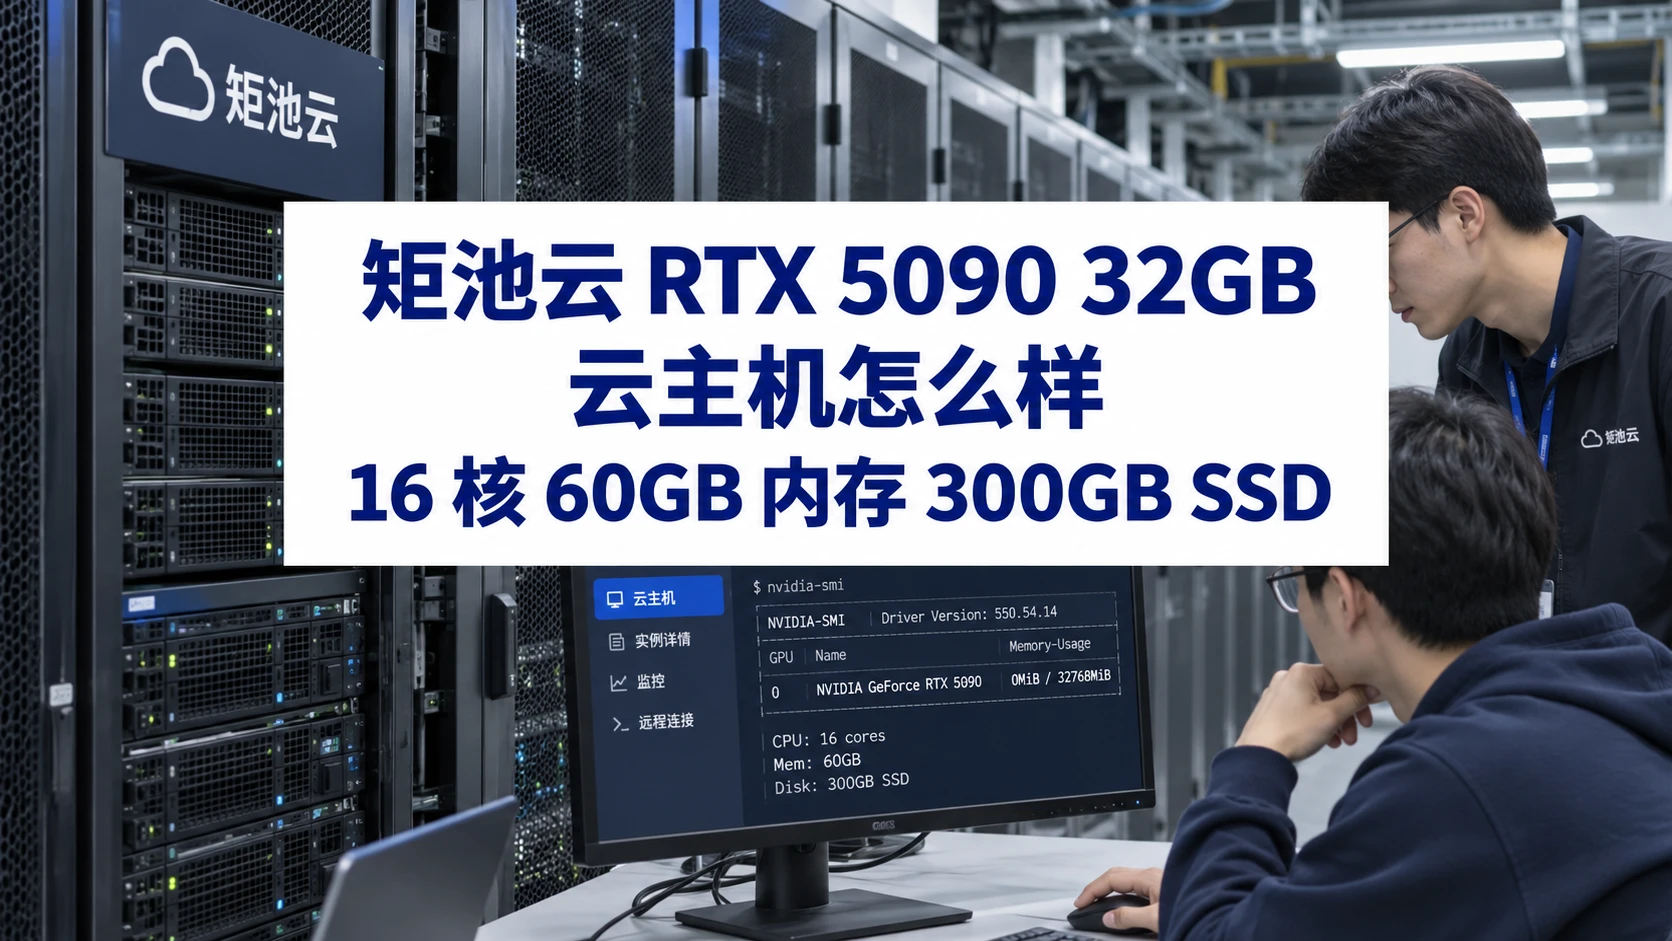
这是一台以 GeForce RTX 5090 32GB 为核心的 GPU 云主机实例。矩池云官方 GPU 云服务器页中,该规格是 1 张 RTX 5090、32GB GPU 显存、16 核 CPU、60GB 系统内存和 300GB SSD;这里的“32GB”首先是单卡显存容量,它决定模型权重、KV Cache、推理框架工作区和并发请求能否同时放入 GPU。
RTX 5090 32GB 的硬件基础
NVIDIA 的 《GeForce RTX 5090 Graphics Cards》 官方文档表明,将 RTX 5090 列为了 NVIDIA Blackwell 架构显卡,并标注 32GB GDDR7 显存、21,760 个 NVIDIA CUDA Core 与第五代 Tensor Core。对大模型推理来说,32GB 显存是比“显卡名称”更直接的选型号的起点:它提供了装载权重和保留运行时空间的物理上限。
不过,NVIDIA 公版资料描述的是 GPU 级别规格,不等于云端实例的最终服务能力。云端的实际体验还会受到驱动、CUDA 与框架版本、功耗策略、CPU 内存、存储读写、网络和当前负载影响。选型时应该仔细阅读官方参数作为硬件参照,再把所租实例和自己的基准测试为准。
矩池云 RTX 5090 32GB实例适合部署哪些大模型
Qwen3-14B BF16大模型
Qwen3-14B BF16 的规格的部署模型。以 14B 参数量估算,BF16 权重本身已经接近 28GB;而上线时还要给框架工作区、KV Cache、上下文和请求波动留出空间。所以“32GB 可以放下权重”不应被理解为可以在任意上下文、任意并发下稳定运行。建议先设定较保守的上下文长度和并发,再观察显存峰值、首 token 延迟与排队时间。
Qwen3-32B AWQ大模型
Qwen3-32B AWQ的规格的部署模型。AWQ 属于量化路径,目的是降低模型权重的显存占用,使更大参数规模的模型有机会进入单张 32GB 显存的部署范围。但量化不只是一项“能装下”的开关:模型实现、量化格式、推理后端、最大上下文、batch 与并发都会影响最终可行性。部署前应读取模型卡和框架文档,使用目标 prompt 长度压测,而不是只按参数量做结论。
16 核、60GB 内存和 300GB SSD 有什么作用
在 GPU 推理中,16 核 CPU 不直接替代 GPU 算力,但会参与请求解析、分词、前后处理、日志、Web 服务和容器调度。对于带检索、文件处理或多个应用进程的服务,CPU 余量会影响整体响应的稳定性。60GB 系统内存 适合承载操作系统、容器、缓存和辅助服务;但它不是 GPU 显存的等价替代,依赖 CPU offload 往往会带来更高的数据传输开销。
300GB SSD 主要承担模型权重、容器镜像、依赖缓存、日志和数据文件。实际容量是否够用,取决于是否要保留多个模型版本、是否下载大型基础镜像、是否生成大量日志或数据集。开始前最好预估“模型文件 + 镜像 + 缓存 + 余量”,避免实例能启动却因磁盘空间不足中断更新。
租用前最好核对的五项内容
1. 显存的预算与目标工作负载多少
明确权重精度、量化格式、最大上下文、预期并发和最大输出长度;不要把单用户短对话的显存占用当作生产上限。
2. 驱动、CUDA 与推理框架版本
NVIDIA 《CUDA Compatibility》官方文档说明驱动与 CUDA 兼容性需要按版本组合判断。下单后先检查 `nvidia-smi`、镜像里的 CUDA 版本,以及 PyTorch、vLLM 或其他推理框架是否相互兼容。
3. 镜像、端口和数据持久化
确认是否有合适的基础镜像、容器权限、端口暴露方式、SSH/Jupyter 入口,以及重启或释放实例后模型与数据如何保存。开发验证和持续在线服务的需求并不相同。
4. 网络、访问控制与成本边界
检查公网带宽、流量规则、可否配置安全组或反向代理;同时确认按量、包月、关机计费、磁盘和公网 IP 是否单独计费。不要只拿卡时单价比较总成本。
5. 用真实流量做小规模验证
先用真实语料测试加载耗时、显存峰值、首 token 延迟、生成速度、并发排队和异常恢复,再决定是否扩大使用量。这样比根据显卡营销参数直接承诺 QPS 更可靠。
常见问题
RTX 5090 32GB 可以直接部署所有 32B 模型吗?
不能直接这样判断。权重精度和量化方式决定基础占用,KV Cache、上下文长度、batch、并发和框架工作区同样占用显存。以官方模型卡和实际压测结果为准。
实例页的推荐模型是不是保证可用于生产?
不是。推荐模型说明该配置具有相应的部署方向,但生产可用性还取决于流量、延迟目标、版本组合、可观测性和容灾要求。建议把它当作选型起点。
为什么同样是 RTX 5090 云主机,价格和体验会不同?
除了 GPU,CPU 内存、磁盘、网络、机房、驱动镜像、供应与计费策略都不同。比较时应把完整实例配置和实际工作负载放进同一张表,而不是只比 GPU 名称。
结语
矩池云 RTX 5090 32GB 云主机 的价值,在于把单张 32GB Blackwell GPU 与 16 核、60GB 内存、300GB SSD 组合为可直接部署的实例。它适合先验证 14B BF16、32B 量化模型等单卡推理方向,但是否能承载目标服务,仍要把显存预算、上下文、并发、软件版本与真实测试一起进行综合判断。
官方资料来源
- NVIDIA 官方文档:GeForce RTX 5090 Graphics Cards https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
- NVIDIA 官方文档:NVIDIA RTX Blackwell Architecture https://images.nvidia.com/aem-dam/Solutions/geforce/blackwell/nvidia-rtx-blackwell-architecture-technical-brief.pdf
- NVIDIA 官方文档:CUDA Compatibility https://docs.nvidia.com/deploy/cuda-compatibility/
- 矩池云官方实例页:GPU 云服务器https://matpool.com/gpu-server
会员留言