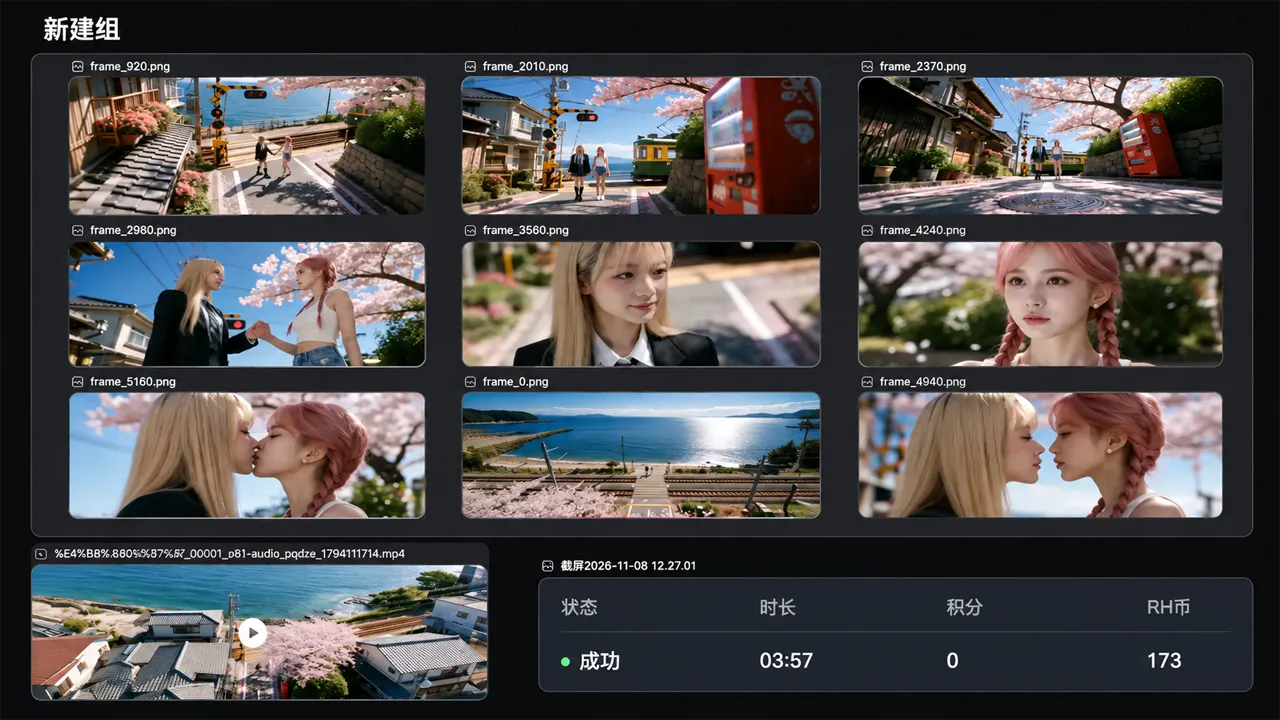
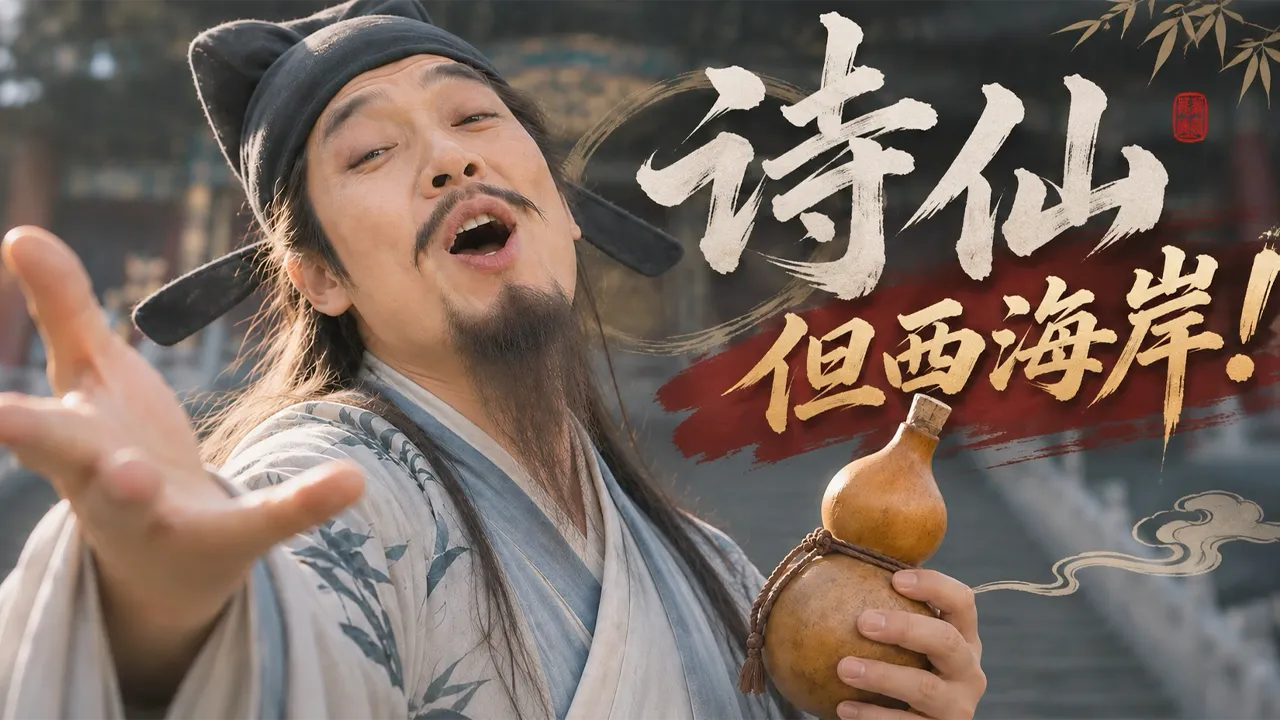
视频工作流:H3_智能一体化-Turbo 加速
这是一套基于 MiniMax H3 与 Goohai MiniMax-H3 Integrated 节点包的参考图音视频生成工作流。相较本站标准版,本变体增加 Turbo LoRA 加速链路,适合对生成耗时较敏感的场景。旧说明中的“4步”与“6步”相互矛盾,原始 JSON 尚未核实,具体采样步数请以下载文件中的采样器和 Sigmas 配置为准;不将名称当作已验证参数。
效果预览
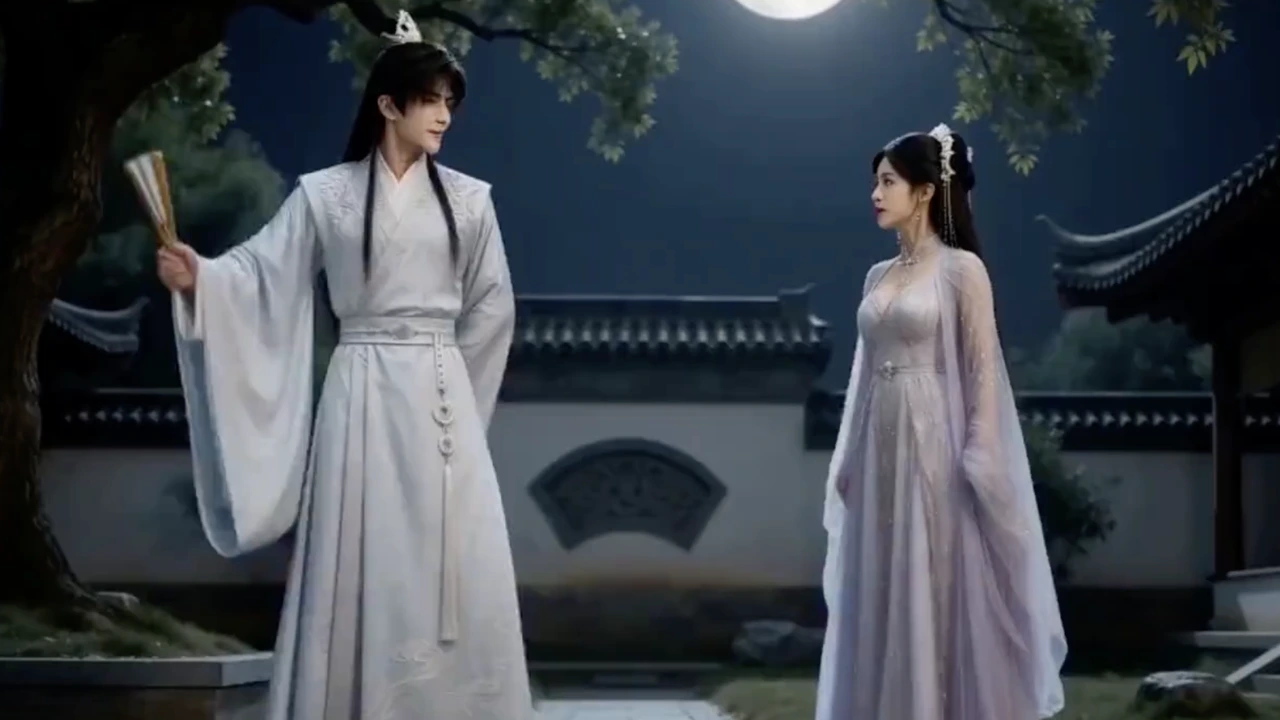
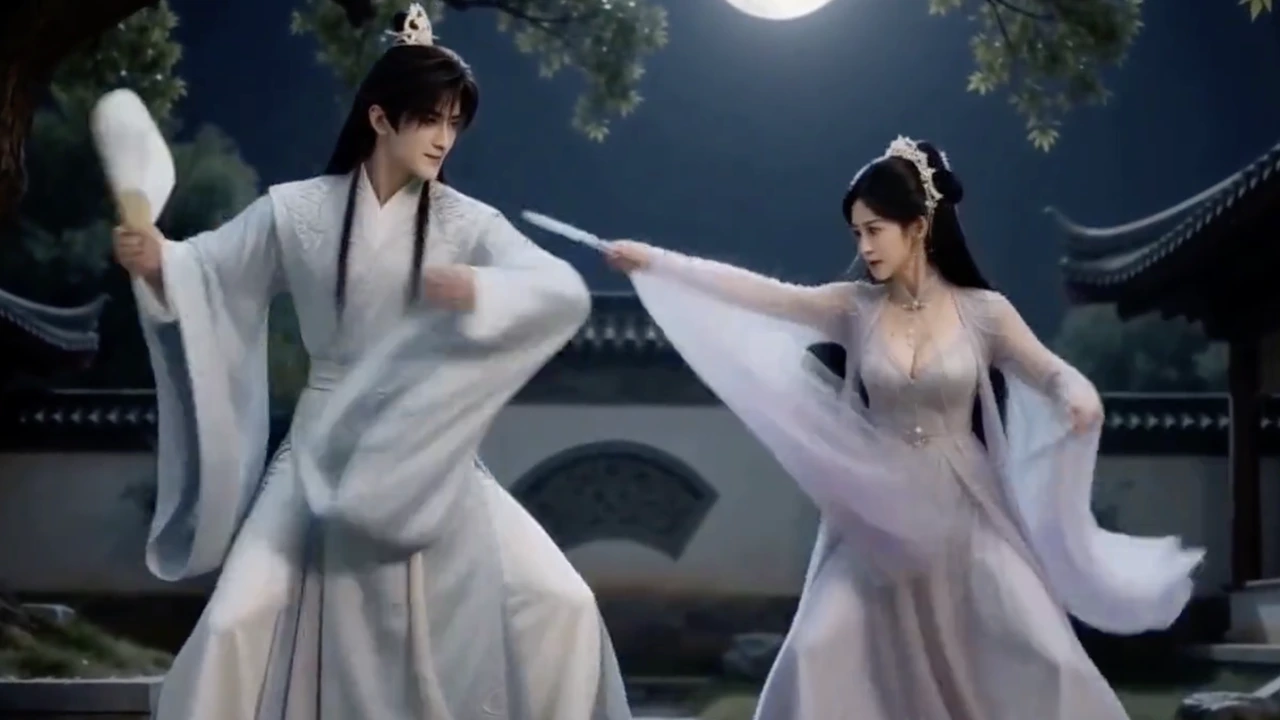
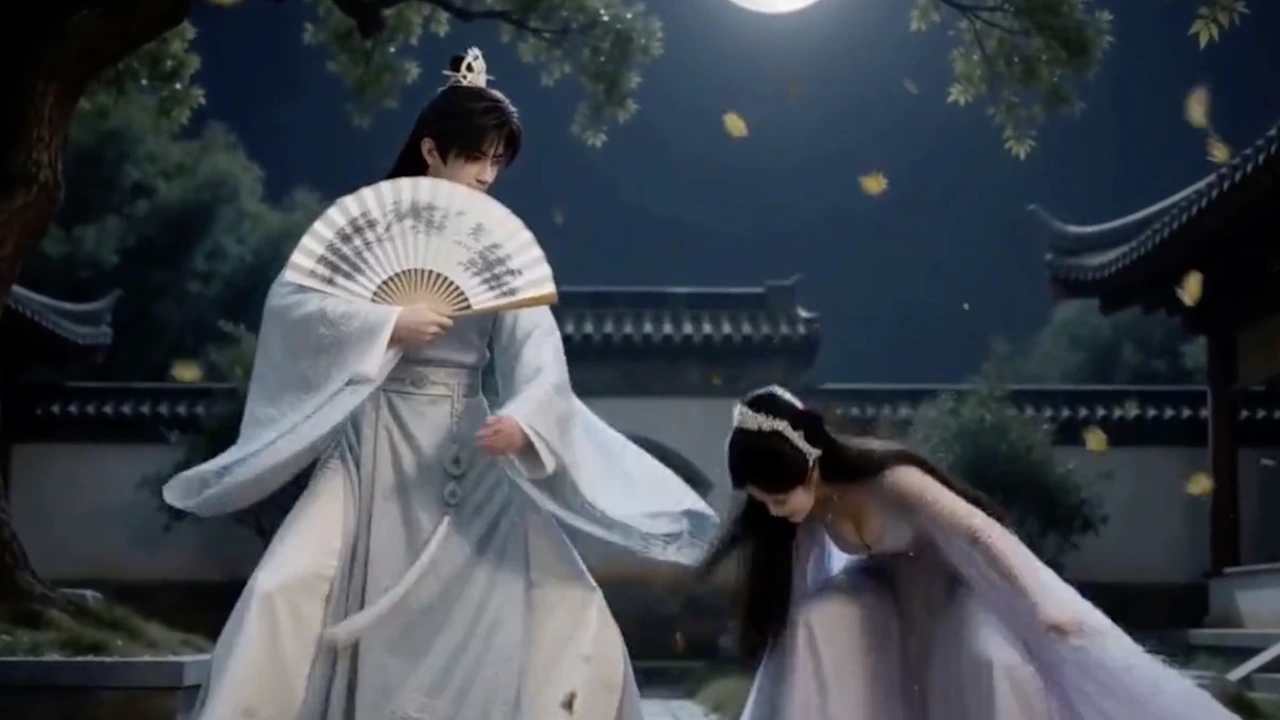
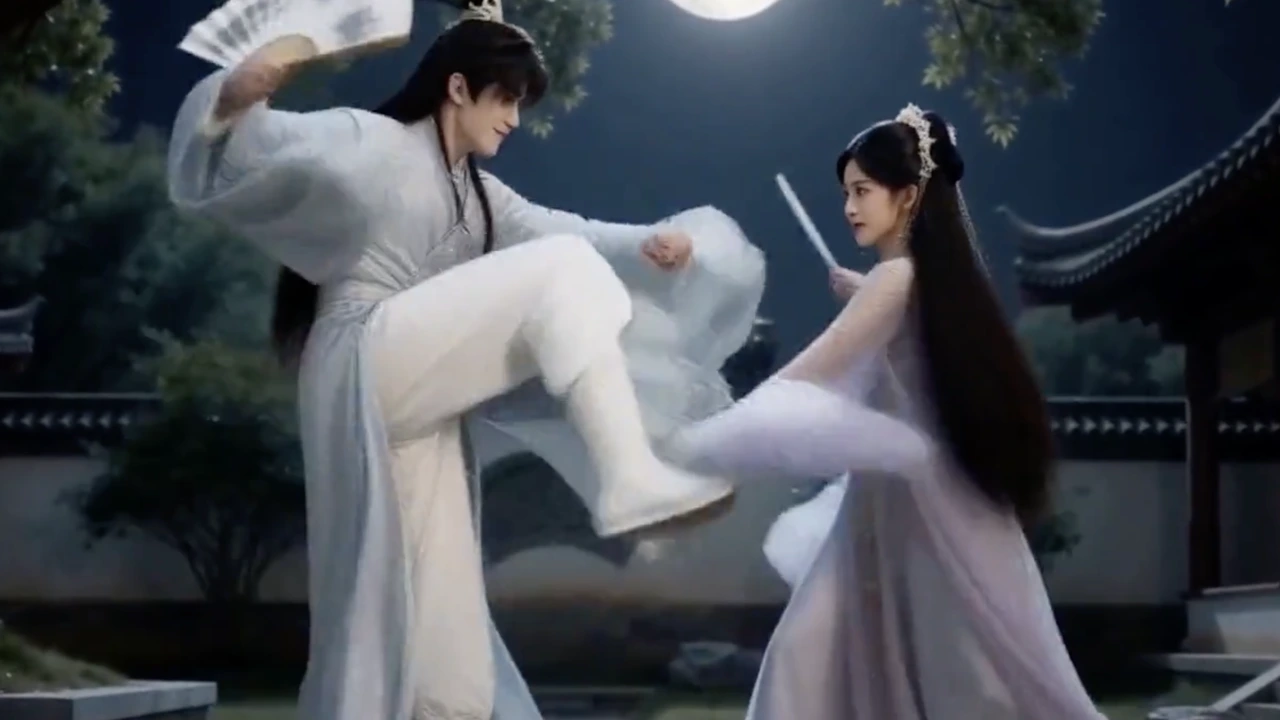
工作流说明
本工作流基于 Goohai MiniMax-H3 Integrated 节点包的「MiniMax-H3智能一体化(GH)」节点,一条链路完成:文本编码(Qwen3-VL)→ 音视频联合采样 → 视频分块解码 → 合成保存,同时带音频输出(音频由模型联合生成)。
- 画面分区:
- Models:双 UNET 加载(主模型 f12va + 参考模型 ref2va)→ H3 适配器(GH)整合
- Sampling:自定义采样器(高级)+ 随机噪波
- Decoding / create video:VAE 解码 → 创建视频(帧率 24)
- 优化:三个 KJNodes 低显存组件串联
- 尾部:Easy-Use 的”如果…否则 / 索引切换”做条件分支;Custom-Scripts 的”播放声音”(notify.mp3,音量 0.2,模式 always)用于跑完提醒
三个变体的差异:
- 原版:直接 20 步采样,无加速 LoRA。
- Turbo 加速:在主模型后挂 MiniMax-H3TurboLoRA 节点(强度 1.00),采样步数大幅降低。low_vram 参数当前选 bypass (sharp, more VRAM)——作者注明:bypass 模式更锐利但更吃显存。
- 分块双采样版:在加速版基础上加「MinimaxH3Latent分块放大(GH)」(latent 放大 1.5 倍,启用分块,避免整帧放大爆显存)+「Minimax-H3二采分块采样器」做二次采样(自定义 Sigmas),时长 15 秒。
下载渠道:在 HuggingFace 搜索文件名关键词(如 minimax_h3_turbo_v4_step600_ema),或从 Goohai MiniMax-H3 节点包的 README 提供的模型链接下载。
2026-11-14 参数核查:原始 JSON 位于网盘,当前无法访问核实。此前“4步”和“6步”均不作为确认结论,实际步数以文件中的采样配置为准。
版本对照:标准版 · Turbo 加速+分块双采样版。
节点结构
节点结构截图待补充
运行环境与硬件要求
需要下载的模型
| 文件 | 类型 | 大小 | 放置目录 | 下载 |
|---|---|---|---|---|
minimax_h3_f12va_int8_convrot.safetensors | UNET 主模型 | models/diffusion_models | ||
minimax_h3_ref2va_int8_convrot.safetensors | UNET (参考 / 第二路) | models/diffusion_models | ||
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | 文本编码器(CLIP 模型) | models/text_encoders | ||
minimax_h3_video_vae_fp16.safetensors | 视频 VAE | models/vae | ||
minimax_h3_audio_vae_fp32.safetensors | 音频 VAE | models/vae | ||
taeh3.safetensors | 微型 VAE (快速预览) | models/vae | ||
minimax_h3_turbo_v4_step600_ema.safetensors | Turbo 加速 LoRA | models/loras |
需要安装的自定义节点
| 节点包 | 用途 | 安装方式 |
|---|---|---|
| Goohai MiniMax-H3 Integrated | MiniMax-H3 智能一体化 (GH) 、 MiniMax-H3 适配器 (GH) 、 MinimaxH3Latent 分块放大 (GH) 、 Minimax-H3 二采分块采样器 | ComfyUI-Manager 搜索安装 |
| ComfyUI-KJNodes (标记 [BETA]) | MiniMaxH3LowVRAMAttention 、 MiniMaxH3ChunkFeedForward 、 MiniMaxH3 内存高效 Sage 注意力补丁、模型贴片 Torch 设置、设置预留虚拟内存、模型预览覆盖 | ComfyUI-Manager 搜索安装 |
| Easy-Use | 如果 … 否则、索引切换 | ComfyUI-Manager 搜索安装 |
| Custom-Scripts | 播放声音 | ComfyUI-Manager 搜索安装 |
使用步骤
- 安装上方节点包
模型放入对应目录(首次加载节点会报缺文件路径,按提示放)。
- 打开对应变体的工作流 JSON
在 ComfyUI 里还原连线。
- 填写正向提示词
Prompt 节点写画面 + 台词描述(画面 + 台词描述,H3 带音频,台词写法按官方 [Chinese] 语法——这是本项目已验证的防"乱读"方案)。
- 按需选变体
日常出片用 Turbo 加速版;要更高分辨率用分块双采样版。
- 随机噪波
自定义采样器(高级)一路跑完,尾部自动保存视频(前缀 video/H3 / video/H3-4 step / video/H3-4 step-2-)并播放提示音。
关键参数说明
| 参数 | 所在节点 | 设置 | 说明 |
|---|---|---|---|
| 采样器名称 | res_multistep | 三个变体一致 | |
| 步数 | 待核实原始 JSON | 旧资料分别出现4步与6步,当前不标注确定步数。应核对采样节点、显式Sigmas与两阶段采样各自配置。 | |
| 降噪 | 1.00 | 全量生成 | |
| 帧率 | 24 | 创建视频节点 | |
| 时长(秒) | 8.5 / 8.0 / 15.0 | 原版 / Turbo 加速版 / 双采样版 | |
| 最大分辨率 | 1024 | 智能一体化节点 | |
| 百万像素 | 1.0 / 0.6 | 原版 / 双采样版首采 | |
| 放大 scale | 1.50 | 双采样版 Latent 放大 | |
| 分块采样 | 启用分块,重叠像素 128 ,对齐像素 32 ,接缝修复 false | 双采样版 | |
| 随机种 | fixed (噪波随机种 222) | 改成 randomize 可每次出不同结果 | |
| 生成后控制 | randomize (种子) / fixed (噪波随机种) | 见工作流 |
常见问题与报错
low_vram 节点选项注明
bypass (sharp, more VRAM)——bypass 模式更清晰但需要更多显存。
设置预留虚拟内存节点有 mode
auto 与固定 GB 两种模式,自动最大预留量 39.9 表示按系统情况自动扩展。
报缺模型文件
报错信息会给出期望的子目录名,把模型放进该目录后点刷新(R)。
显存 OOM
确认"优化"组三个 KJNodes 节点都接入模型链;再不够就把 low_vram 从 bypass 切到另一档。
长视频爆显存
用分块双采样版(分块采样 + 重叠像素控制接缝)。
音频缺失/不同步
确认音频 VAE(fp32)文件在位,is_original_audio / mux_audio 分支接线正确。
更新记录
- 原版基础 20 步版本
- Turbo 加速增加 Turbo LoRA (v4_step600_ema)
- Turbo 加速 + 分块双采样增加 Latent 3D 放大器 + 二采分块采样器,时长扩到 15s