ComfyUI · 视频
视频工作流:LTX2.3时间线控制单图生视频工作流
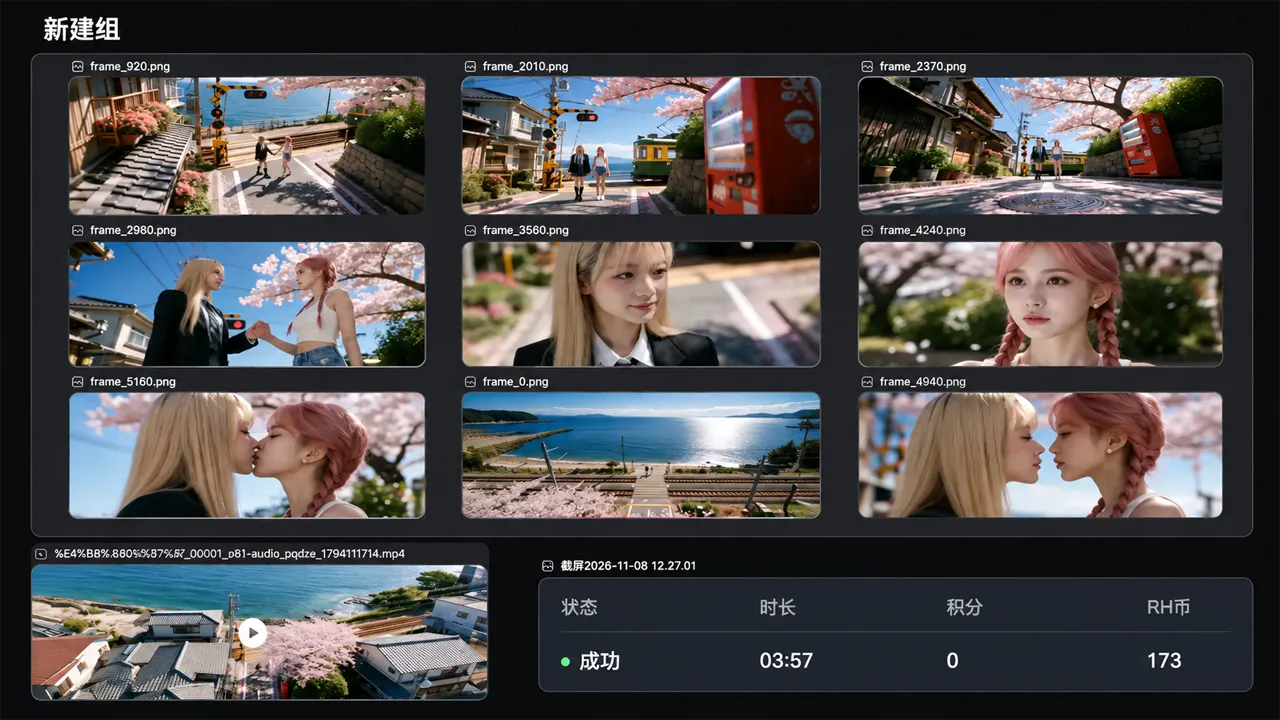
用一张参考图 + 一条带时间轴分镜的提示词,生成 25fps、最长 301 帧的带音频短视频。
ComfyUI单图 + 时间线提示词 → 带音频的叙事视频 免费获取 难度:中级 LTX2.3图生视频时间线提示词带音频视频AI视频生成
效果预览
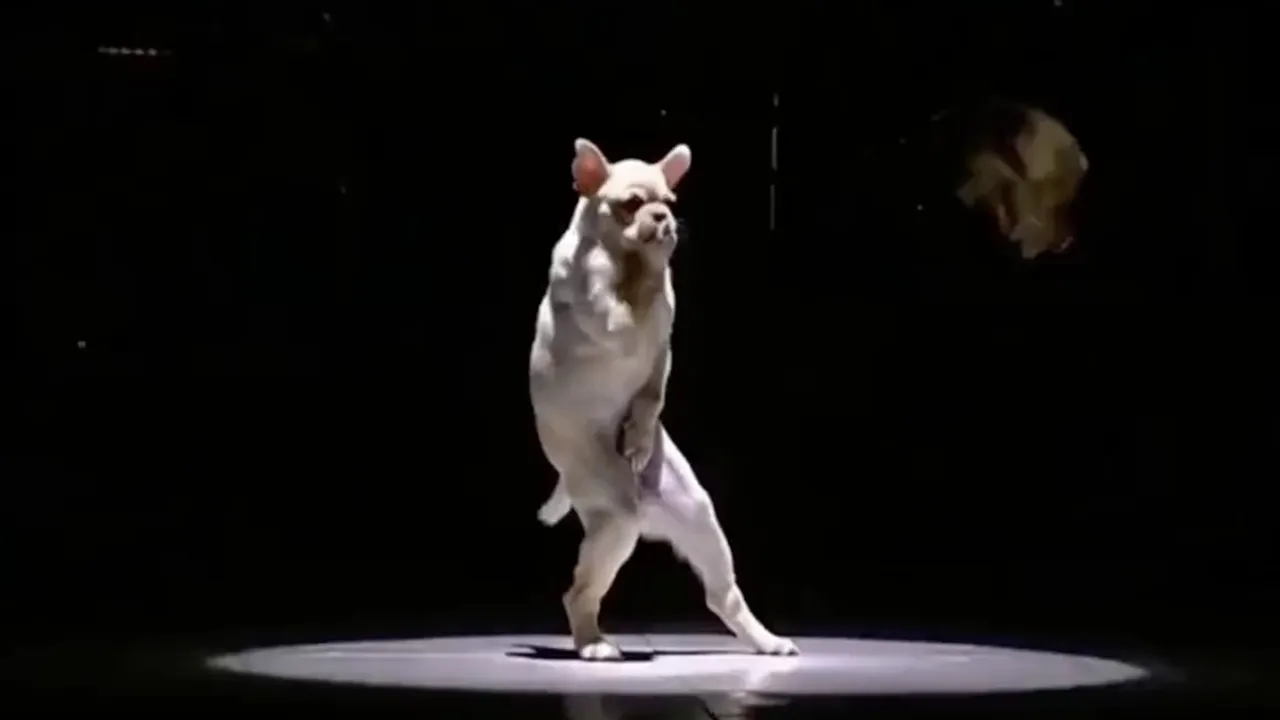
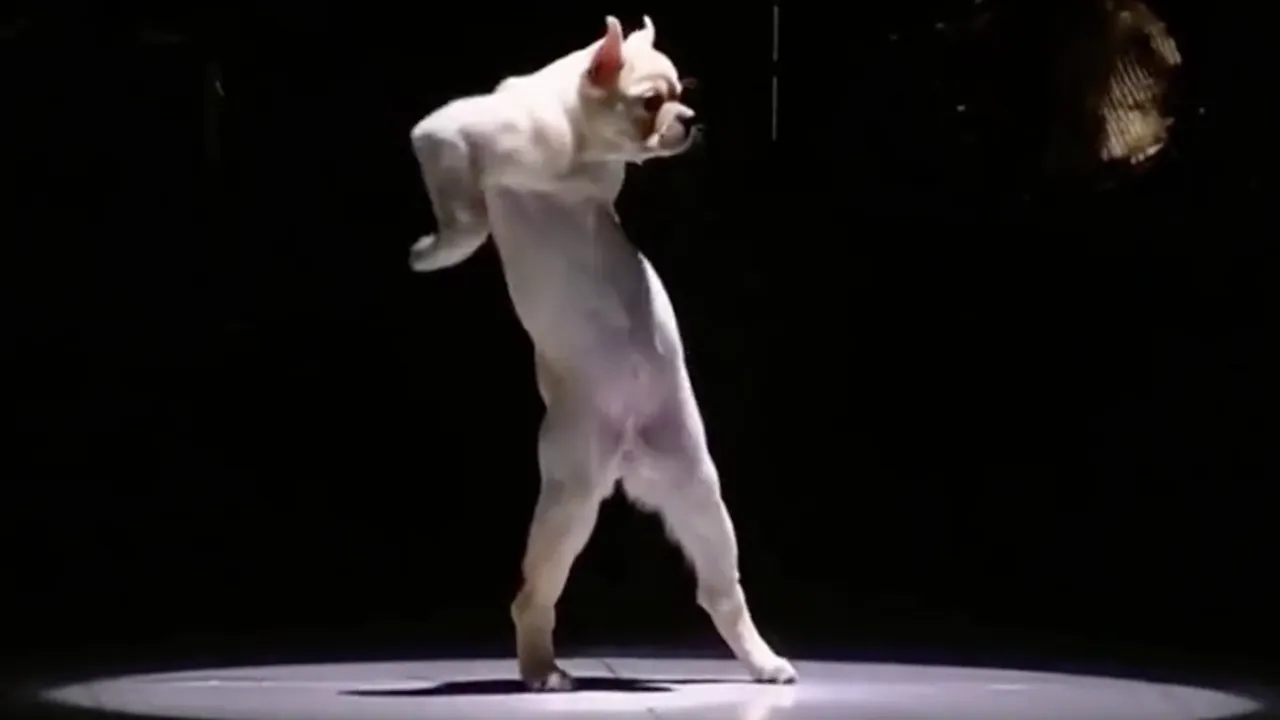
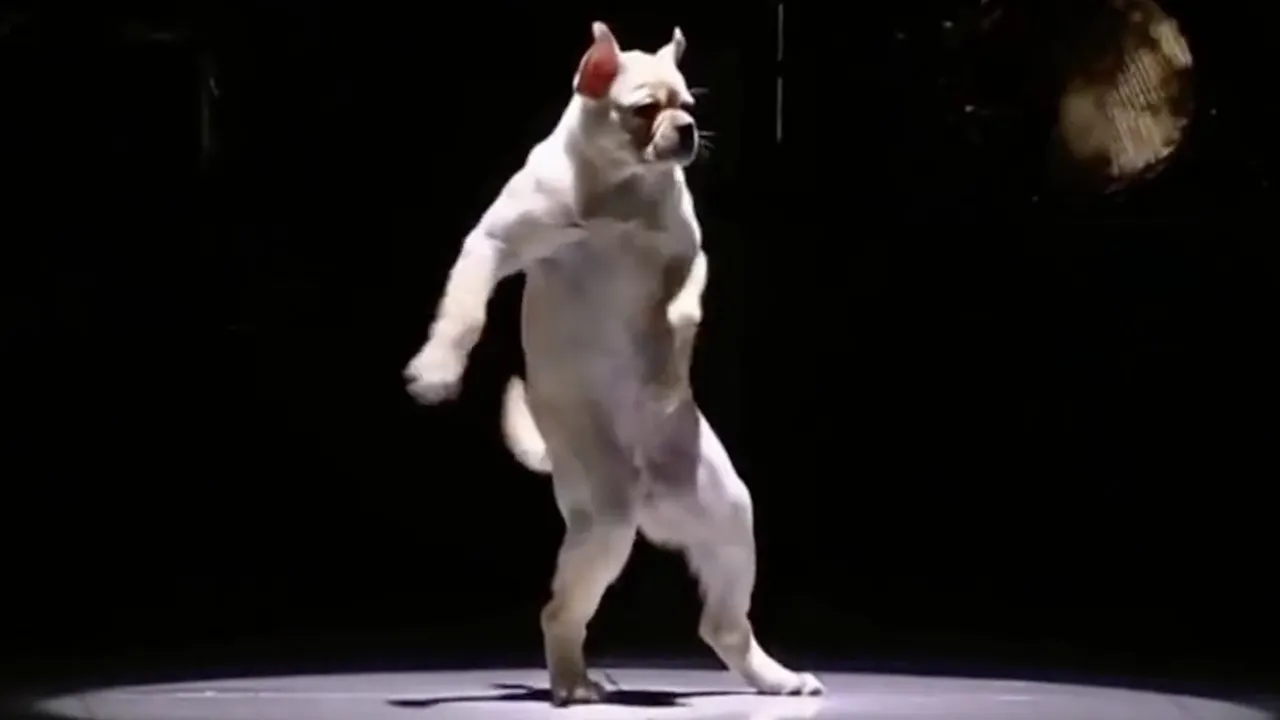
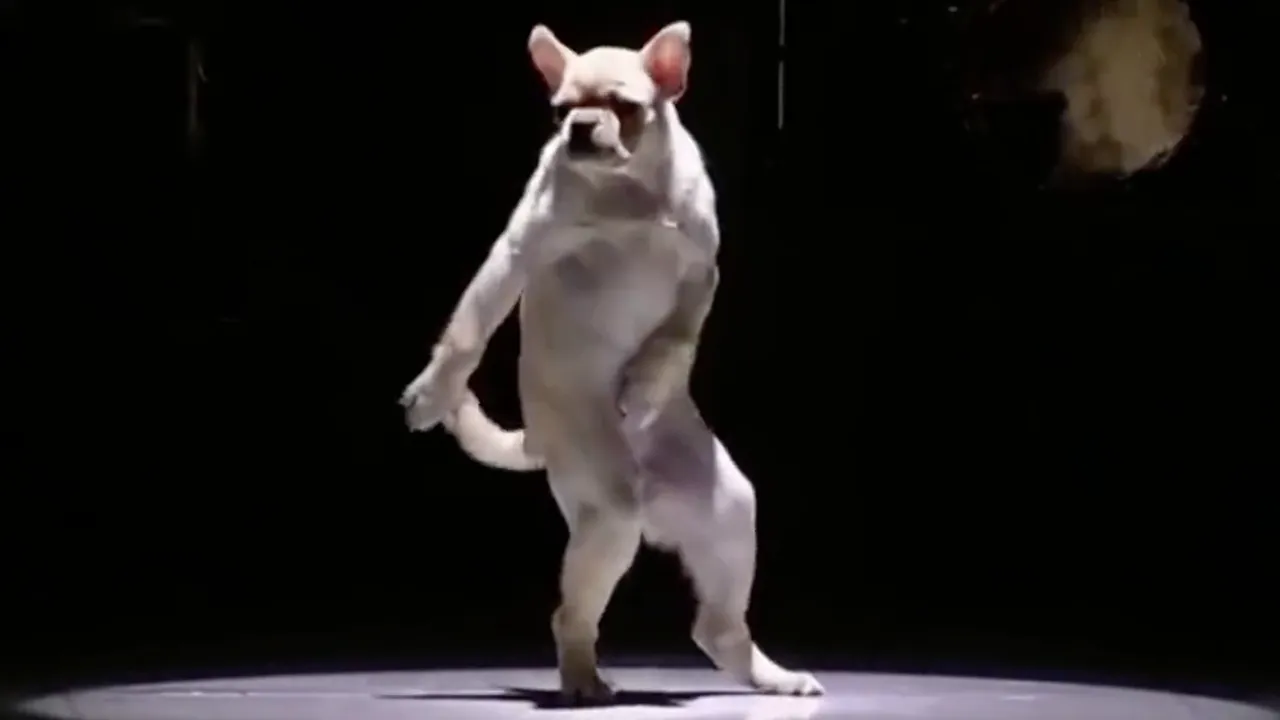
工作流说明
用一张参考图 + 一条带时间轴分镜的提示词,生成 25fps、最长 301 帧的带音频短视频。画面分区:
- 模型选择:UNET(distilled 蒸馏版)+ 双 CLIP(Gemma 3 12B + LTX text projection)+ 双 VAE(主 VAE + 音频 VAE)+ Latent 放大模型
- 提示词分镜:PromptRelay-main 的「提示词中继编码 (时间轴)」节点——在一个节点里按时间轴写多段镜头描述,模型按时间顺序演绎
- 采样参数:NAG 标准化注意力引导(KJ)+ 自定义采样器 + LTXV条件设置 + 引导裁剪
- 视频生成:LTXV 音频视频分离 Latent → 画面 Latent / 音频 Latent 分路 → VAE 解码 / LTXV音频VAE解码器 → VHS 合并为视频(h264-mp4,crf 19)
- 辅助:LayerStyle 按宽高比缩放参考图 → LTXV预处理;LTX2采样预览覆盖(KJ)用微型 VAE 提速预览
下载渠道:HuggingFace 搜索文件名关键词,或 LTXVideo(Lightricks)节点包 README 的模型链接。
节点结构
节点结构截图待补充
运行环境与硬件要求
22B distilled 模型 fp8_scaled 量化权重加载量约 22GB 级(估算),建议大显存或依赖 offload
音频 VA模型同时生成画面与音频(音频 Latent 分路解码),显存压力高于纯视频 LTX
上下文长帧数(301 帧)单次采样,分段出片请用「无限时长」版工作流
最低显存16 GB
需要下载的模型
| 文件 | 类型 | 大小 | 放置目录 | 下载 |
|---|---|---|---|---|
ltx-2.3-22b-distilled_transformer_only…fp8_scaled.safetensors | UNET 主模型(蒸馏版) | models/diffusion_models | ||
gemma_3_12B_it_fp8_e4m3fn.safetensors | 双 CLIP 之一(文本理解) | models/text_encoders | ||
ltx-2.3_text_projection_bf16.safetensors | 双 CLIP 之二(text projection) | models/text_encoders | ||
ltx-2.3-spatial-upscaler-x2-1.0.safetensors | Latent 放大模型 | models/latent_upscale_models | ||
LTX23_video_vae_bf16.safetensors | 视频 VAE | models/vae | ||
LTX23_audio_vae_bf16.safetensors | 音频 VAE | models/vae | ||
taeltx2_3.safetensors | 预览用微型 VAE | models/vae |
需要安装的自定义节点
| 节点包 | 用途 | 安装方式 |
|---|---|---|
| LTXVideo(Lightricks) | LTXV 预处理、 LTXV 条件设置、 LTXV 添加引导、 LTXV 引导裁剪、 LTXV 音频视频分离 Latent 、 LTXV 音频空 Latent 、 LTXV 音频 VAE 解码器、 LTXV 合并视频 Latent 、空 LTXVLatent 视频 | ComfyUI-Manager 搜索安装 |
| ComfyUI-KJNodes | LTX2 标准化注意力引导 (NAG) 、 LTX2 采样预览覆盖、 VAE 加载程序、视频最长边、总帧数、 LTX 视频将图像转换为视频 | ComfyUI-Manager 搜索安装 |
| PromptRelay-main | 提示词中继编码(时间轴) | ComfyUI-Manager 搜索安装 |
| VideoHelperSuite | 合并为视频 | ComfyUI-Manager 搜索安装 |
| LayerStyle | 图层工具:按宽高比缩放 _V2 | ComfyUI-Manager 搜索安装 |
| essentials / Easy-Use / Custom-Scripts 等 | 图像缩放、 K 采样器选择、可视化 sigma 值等 | ComfyUI-Manager 搜索安装 |
使用步骤
- 装节点、放模型
- 「模型选择」区把所有加载器填好模型文件名
- 上传参考图到「加载图像」
LayerStyle 缩放后进 LTXV预处理。
- 在「提示词中继编码 (时间轴)」里按时间轴写分镜
每段一个镜头描述,单段内含场景、人物动作、台词(台词用官方 [Chinese] 语法防乱读)。
- 确认视频参数
「视频参数调节」确认总帧数 301 / 25fps / 最长边 1024。
- Queue 跑图
输出为 h264-mp4(crf 19,前缀 ltx2.3)。
关键参数说明
| 参数 | 所在节点 | 设置 | 说明 |
|---|---|---|---|
| NAG alpha / tau / 缩放 | 0.250 / 2.500 / 11.000 | 标准化注意力引导三件套,控制提示词遵循度 | |
| CFG | 1.0 | 蒸馏模型固定低 CFG | |
| 采样器 / 调度器 | euler_ancestral / linear_quadratic | ||
| 步数 | 见工作流(K 采样器选择区) | 蒸馏版步数少 | |
| 最大帧数 | 301 | 约 12 秒 @25fps | |
| 帧率 | 25.0 | ||
| 视频最长边 | 1024 | KJNodes 节点统一控制 | |
| 预览速率 | 8.00 | 采样预览覆盖,跳帧预览提速 | |
| 图像压缩率 | 18 | LTXV 预处理 | |
| epsilon | 0.0010 | VAE 加载程序参数 | |
| 负面提示词 | text, subtitles, logo, stillimage… + 中文负面(相机移动、侧脸、变形嘴唇等) | 工作流里有完整默认负面词,直接沿用 |
常见问题与报错
音频轨是空/爆音
确认音频 VAE 走的是 LTXV音频VAE解码器,不要和视频 VAE 混接。
画面不动(still video)
检查负面词里是否误保留了 stillimage / frozen 类词(该负面词列表里故意包含这些词来抑制静止)。
分辨率报错
LTX 要求尺寸对齐,四舍五入到倍数 32 节点别断开。
单段时长不够用
本版上限 301 帧,更长内容改用「无限时长音频驱动数字人」版的分段循环方案。
更新记录
- 单图生视频基础版