ComfyUI · 视频
全能工作流:MiniMax H3- 1080P 短剧导演台
本地跑的 1080P 级 H3 短剧生成台,核心是解决高分辨率下的显存问题。
ComfyUI1080P 短剧视频生成 免费获取 难度:高级 MiniMax H31080PAI短剧Sage Attention块交换
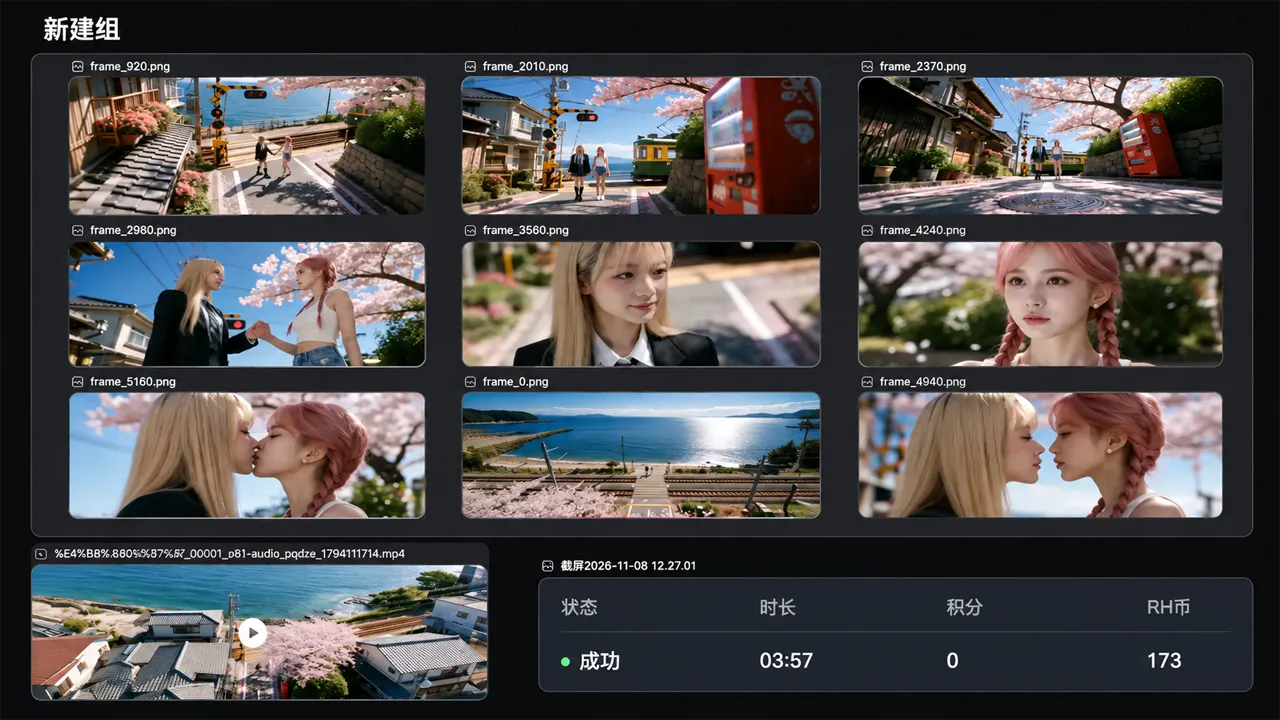
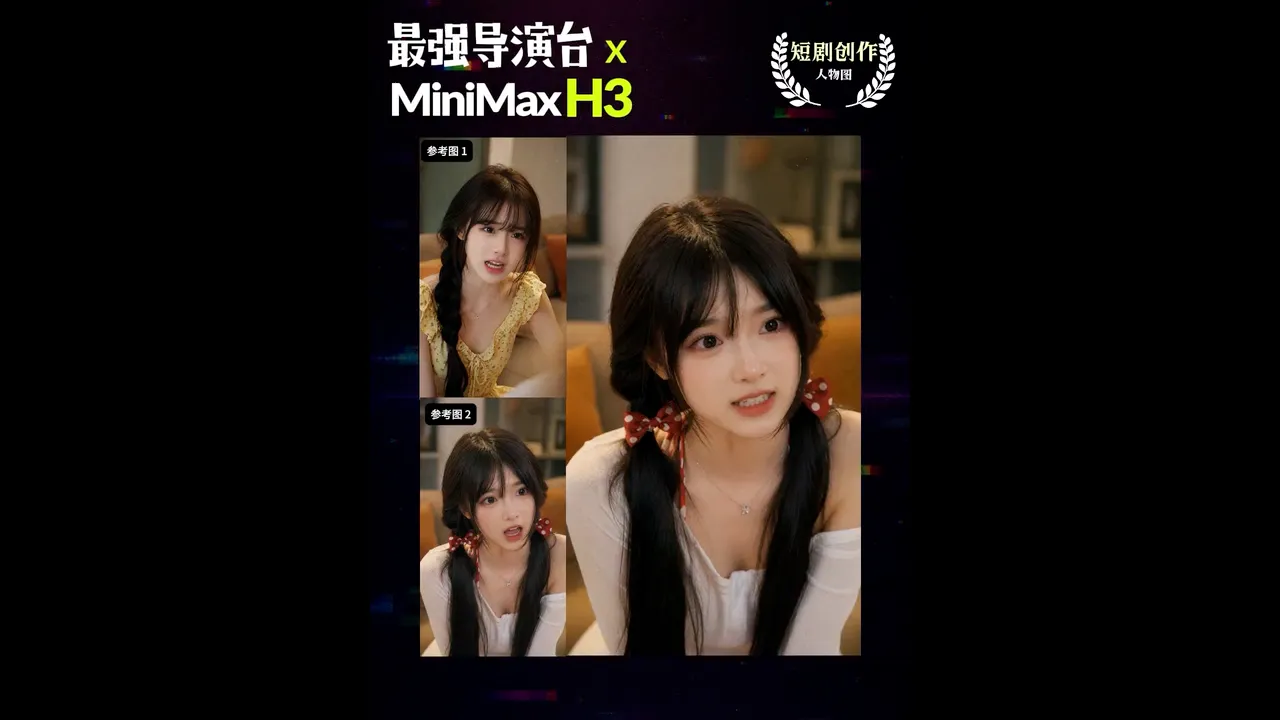
效果预览
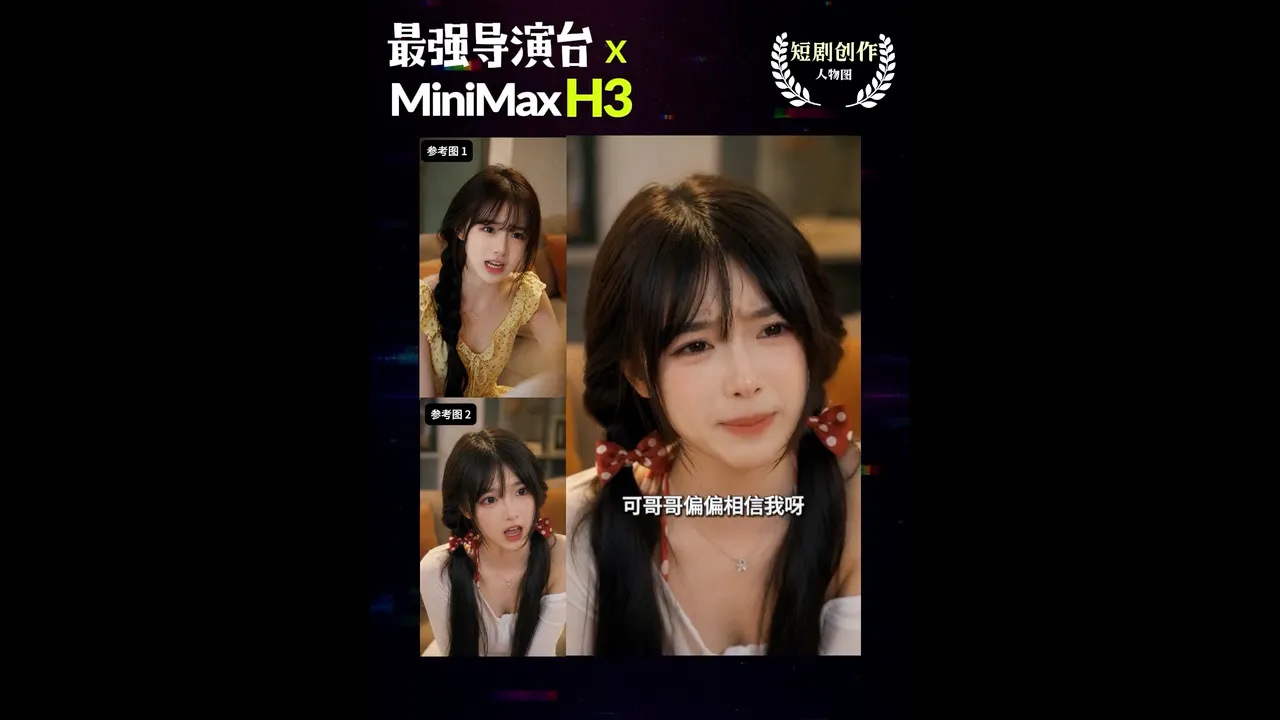
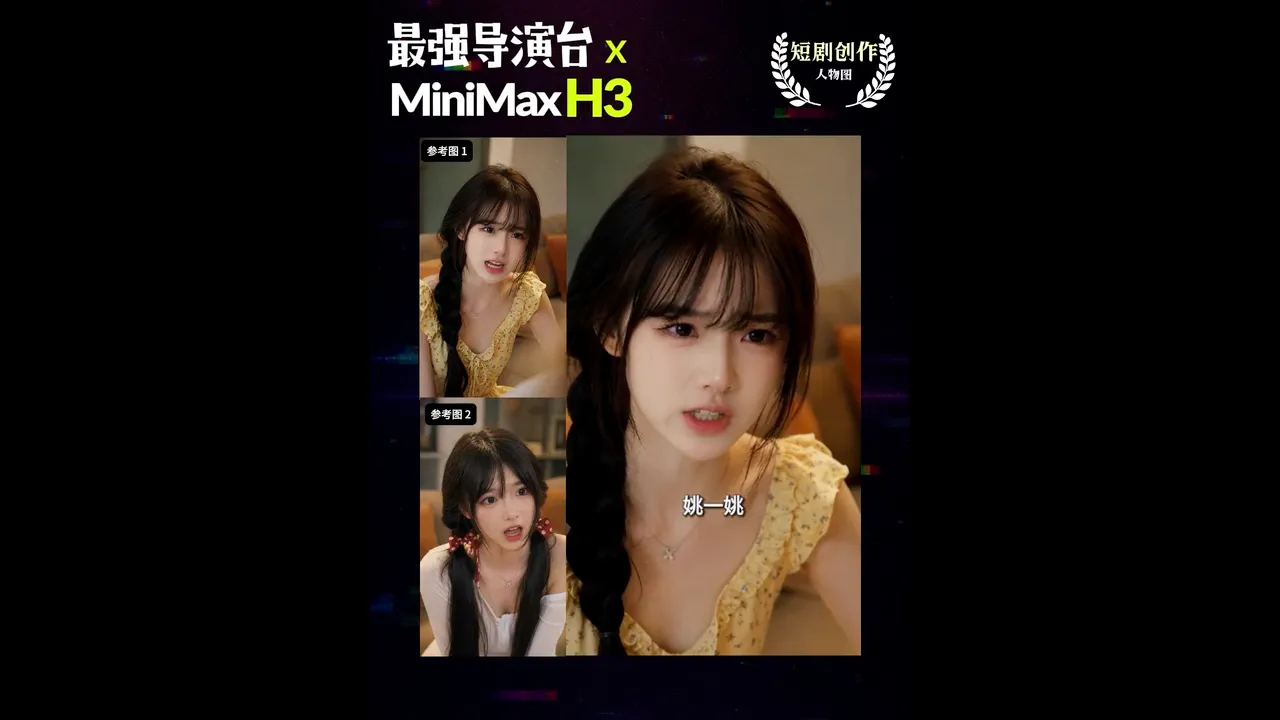
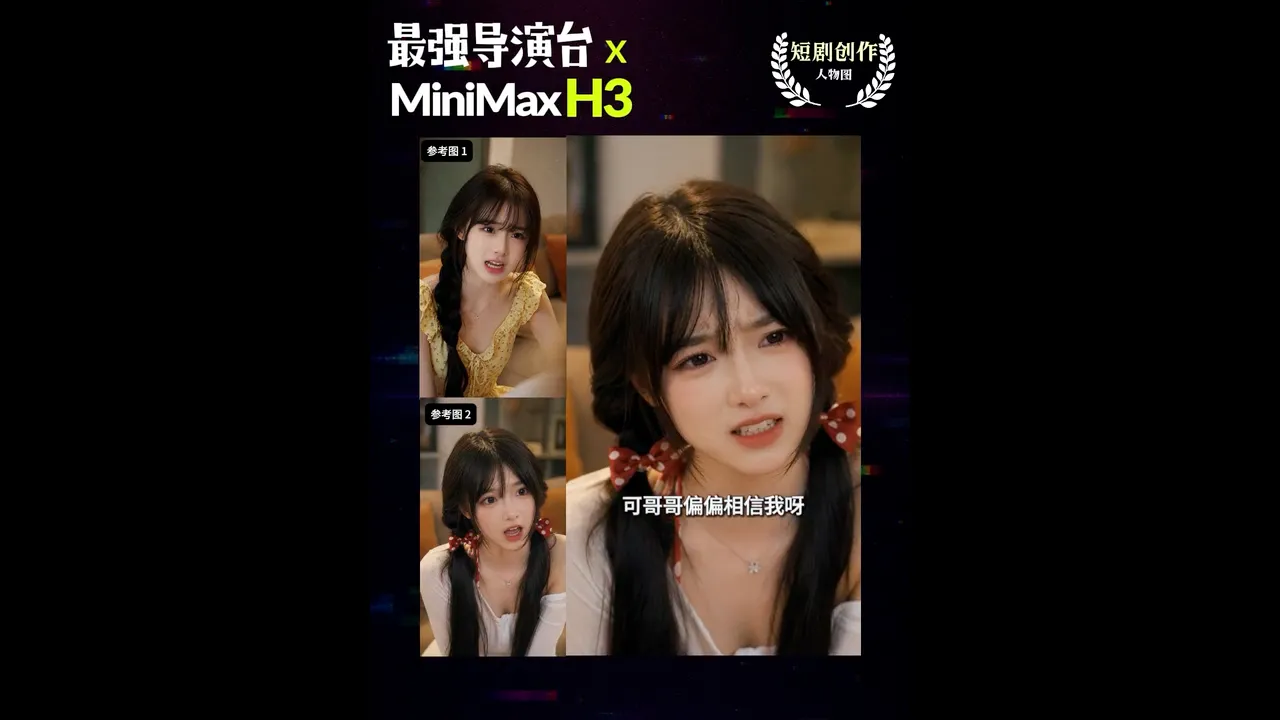
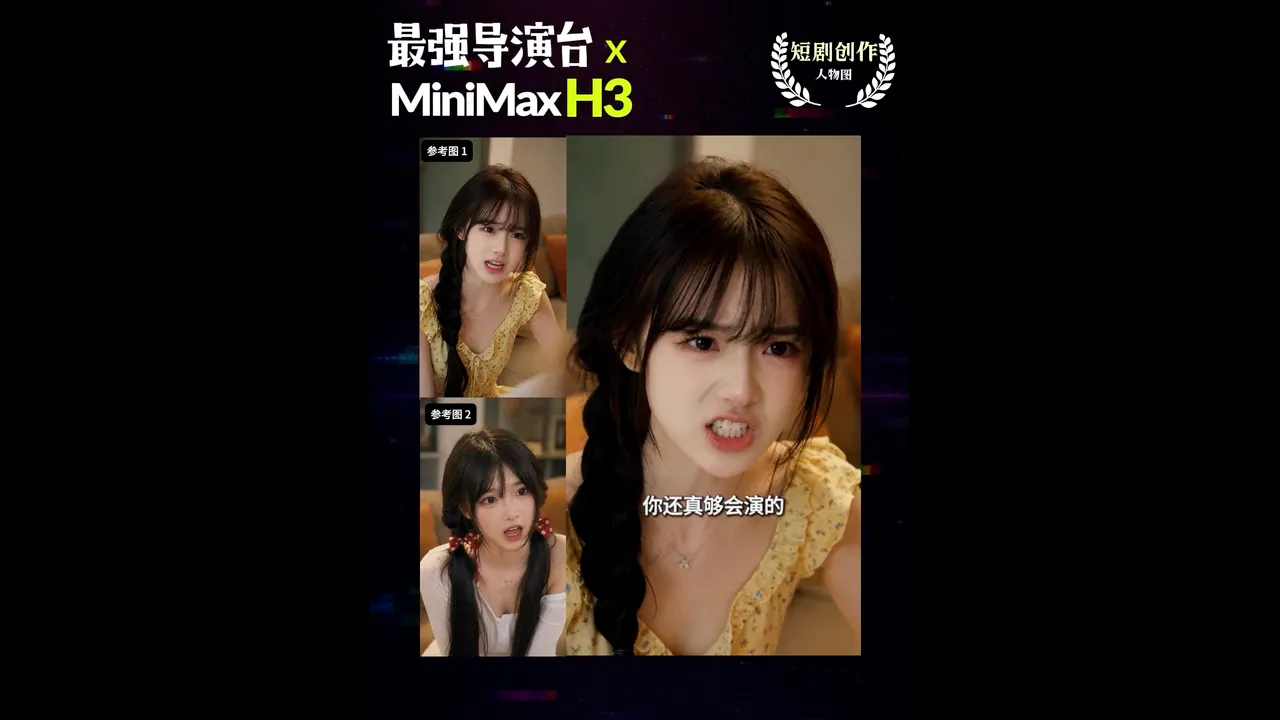
工作流说明
本地跑的 1080P 级 H3 短剧生成台,核心是解决高分辨率下的显存问题。工作流分两个区:
- 模型加载
- Load Diffusion Model:minimax_h3_hybrid_f12va_ref2va_b25-4…(hybrid 混合模型,f12va + ref2va),weight_dtype: default- #45 KJNodes Patch Sage Attention(allow_compile false)→ #94 KJNodes MiniMax H3 Memory Efficient Sage Attention(低显存注意力方案)
- #59 Easy-Use If else + Simple Math Dual:按公式算分辨率(int_1 / int_2 / float_1 / float_2,公式形如 (a + 32*c – 1) // (c*32) * …),把尺寸对齐到 32 的倍数
- Lora、MiniMax H3 To Video(mode: reference、ref_image_size: match,输入口含 images / audios / videos)
- 低显存优化
- #44 UniBlockSwap:value 1.5、num_blocks -1(块交换,把模型分块在显存/内存间倒腾)
- #80 essentials 配套节点
工作流节点计数:49 个节点 / 111 条连线(N: 49 [9],V: 111),是这批里最重的一套。
工作流 未识别出 VAE/CLIP 的具体文件名(节点参数面板被截断)。补全请以节点报错提示的目录和官方模型名为准——这一项属于待确认,不臆造文件名。
节点结构
节点结构截图待补充
运行环境与硬件要求
运行方式本地 ComfyUI
主模型hybrid f12va+ref2va (混合版,体量大于单模型,估算 20GB 级以上)
目标分辨率1080P 级
显存方案Sage Attention 显存优化 + UniBlockSwap 块交换双保险 —— 专为消费级显存设计
最低显存16 GB
需要下载的模型
| 文件 | 类型 | 大小 | 放置目录 | 下载 |
|---|---|---|---|---|
minimax_h3_hybrid_f12va_ref2va_b25-4…safetensors | DiT 主模型(hybrid 混合版) | models/diffusion_models | ||
Lora | 加速 / 风格 LoRA | models/loras | ||
VAE / audio_vae (MiniMax H3 To Video 的输入口) | 视频 VAE 、音频 VAE | models/vae | ||
CLIP / 文本编码器 | 工作流 MiniMax H3 To Video 有 clip 输入口 | models/text_encoders |
需要安装的自定义节点
| 节点包 | 用途 | 安装方式 |
|---|---|---|
| ComfyUI-KJNodes | Patch Sage Attention 、 MiniMax H3 Memory Efficient Sage Attention | ComfyUI-Manager 搜索安装 |
| Easy-Use | If else 、 Simple Math Dual | ComfyUI-Manager 搜索安装 |
| essentials | 配套节点(#80) | ComfyUI-Manager 搜索安装 |
| UniBlockSwap | UniBlockSwap 块交换节点 | ComfyUI-Manager 搜索安装 |
| ComfyUI 内置 | Load Diffusion Model | ComfyUI 内置,无需安装 |
使用步骤
- 装节点、放模型
hybrid 主模型 + VAE + 音频 VAE + CLIP。
- 串上 Sage Attention 补丁
模型链上串两块 KJNodes 的 Sage Attention 节点。
- 设定目标宽高
用 Easy-Use 的 If else / Simple Math 设定,会自动对齐 32 倍数。
- 设置 MiniMax H3 To Video
mode 选 reference、ref_image_size 选 match(按参考图尺寸出片)。
- 显存吃紧时调块交换
调 UniBlockSwap 的 value 与 num_blocks。
- Queue 出片
关键参数说明
| 参数 | 所在节点 | 设置 | 说明 |
|---|---|---|---|
| weight_dtype | default | 主模型精度 | |
| sage_attention | 启用 | 显存优化注意力 | |
| allow_compile | false | 不编译(兼容性优先) | |
| UniBlockSwap value | 1.5 | 块交换强度 | |
| num_blocks | -1 | 自动决定交换块数 | |
| mode | reference | 参考模式 | |
| ref_image_size | match | 输出尺寸跟随参考图 | |
| 尺寸计算 | 对齐到 32 的倍数 | Easy-Use Simple Math Dual | |
| 节点规模 | 49 节点 / 111 连线 | 工作流底部状态 |
常见问题与报错
1080P 直接 OOM
先确认两块 Sage Attention 节点都接上,再调 UniBlockSwap 的 value(加大 = 更多块卸载到内存,速度换显存)。
尺寸报错
让 Easy-Use 的对齐逻辑算,别手填非 32 倍数的宽高。
allow_compile 开 true 报错
Windows 下编译依赖 triton,失败就保持 false。
模型文件缺失
hybrid 模型文件名较长,按节点报错提示的目录完整放置。
更新记录
- v12026-10-31首次整理(示意文件名显示 " 更新双采 - 质量更佳 " ,说明有过一次双采样质量改进)