ComfyUI · 数字人
视频工作流:wan_S2V数字人生成
Wan2.2 S2V(Sound-to-Video)14B:一张人物图 + 一段音频 → 数字人对口型/对动作的视频。
ComfyUI一张人物图 + 一段音频 → 该人物说/唱这段内容的视频(S2V) 免费获取 难度:中级 Wan2.2 S2V数字人音频驱动对口型AI唱歌视频
效果预览
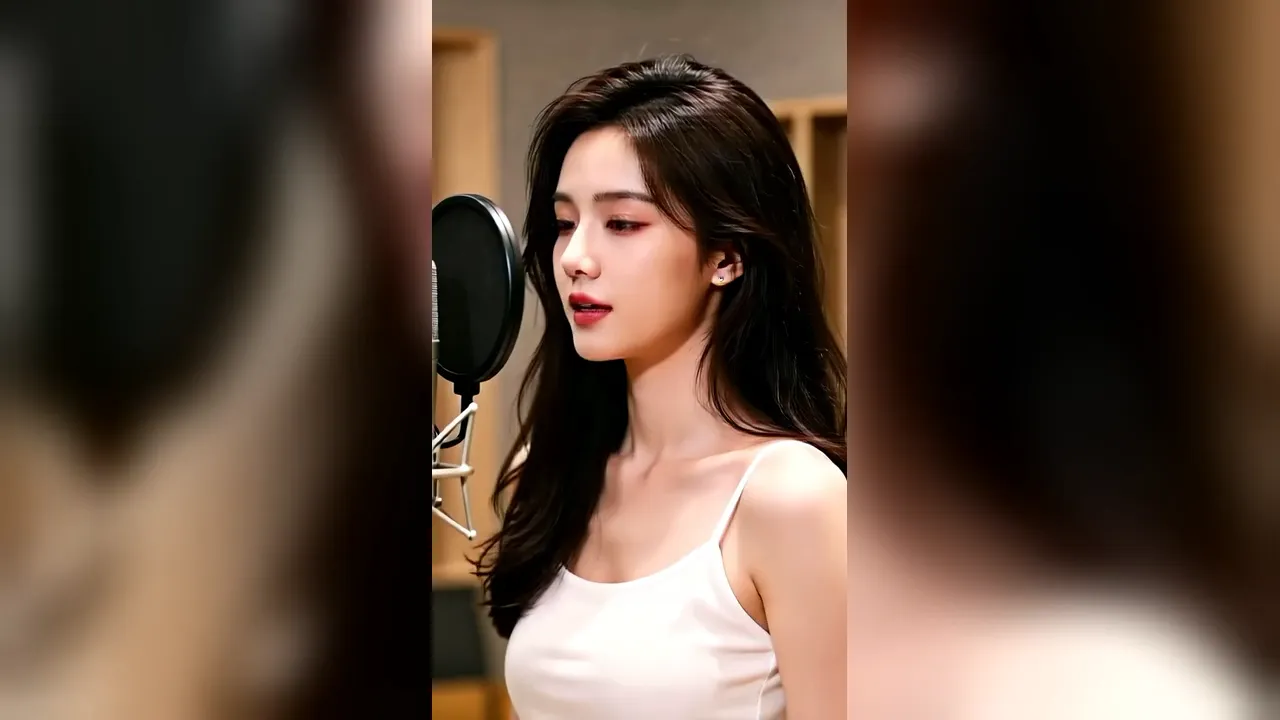
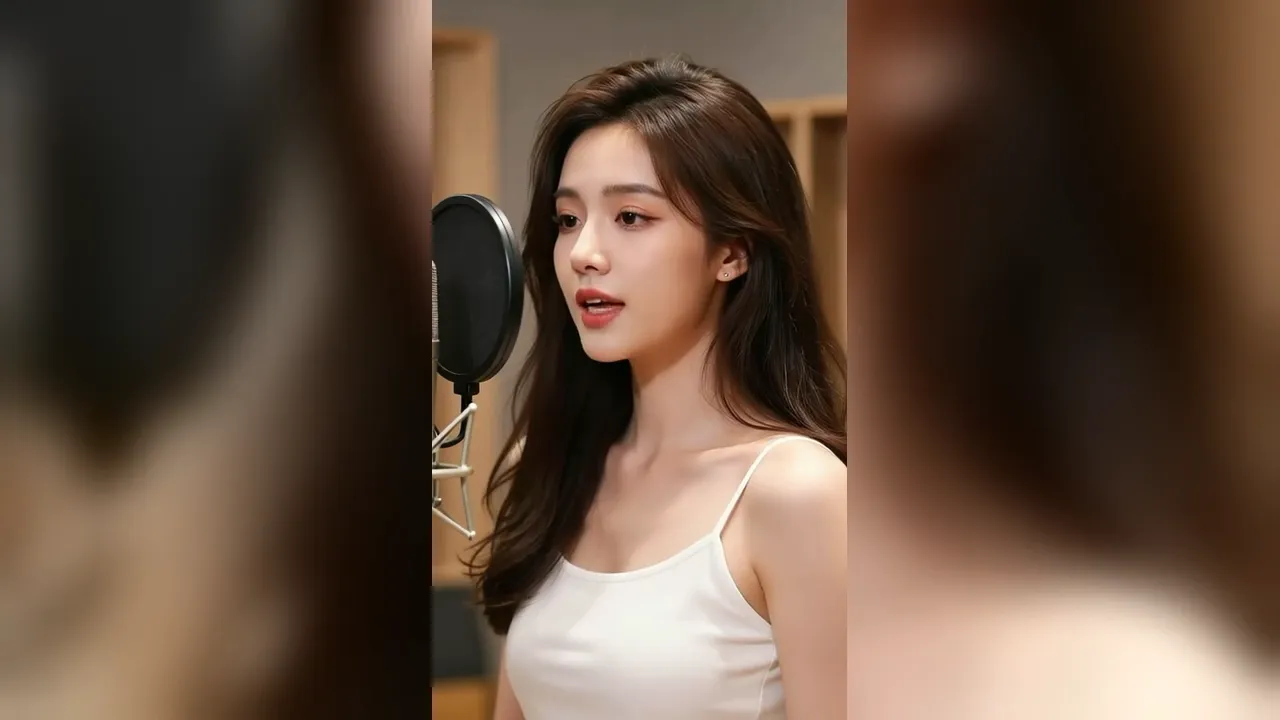
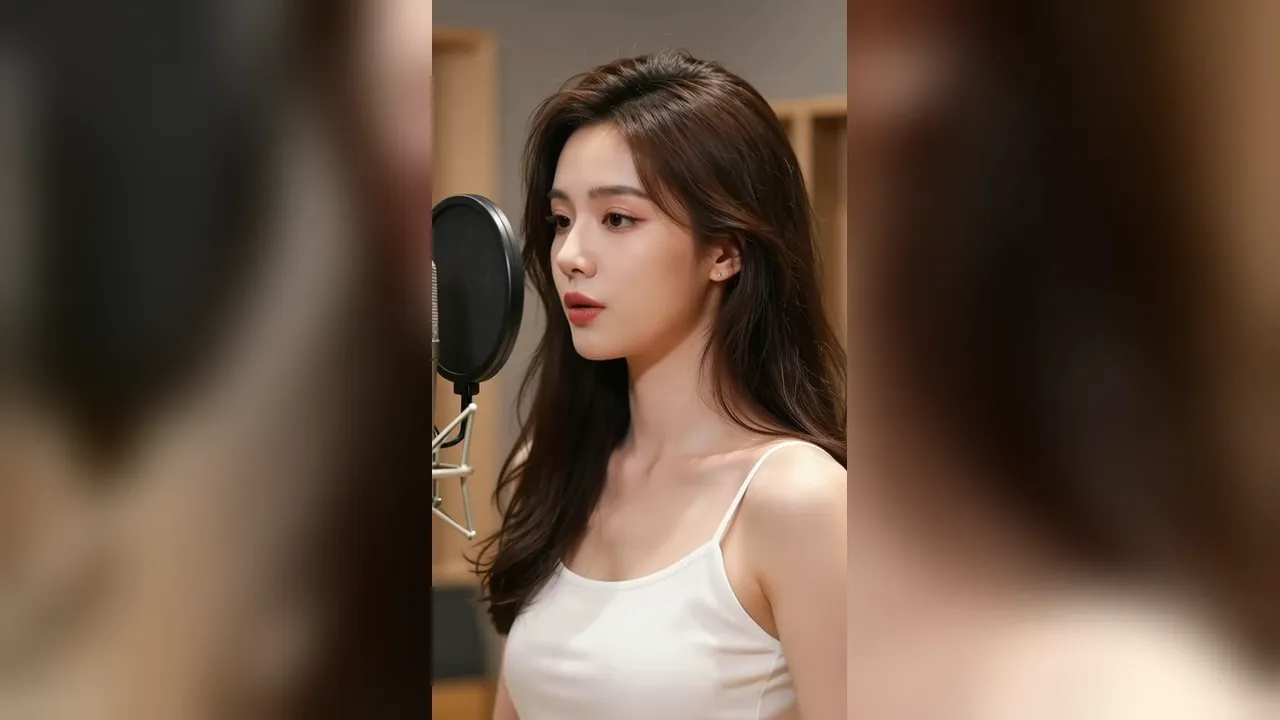
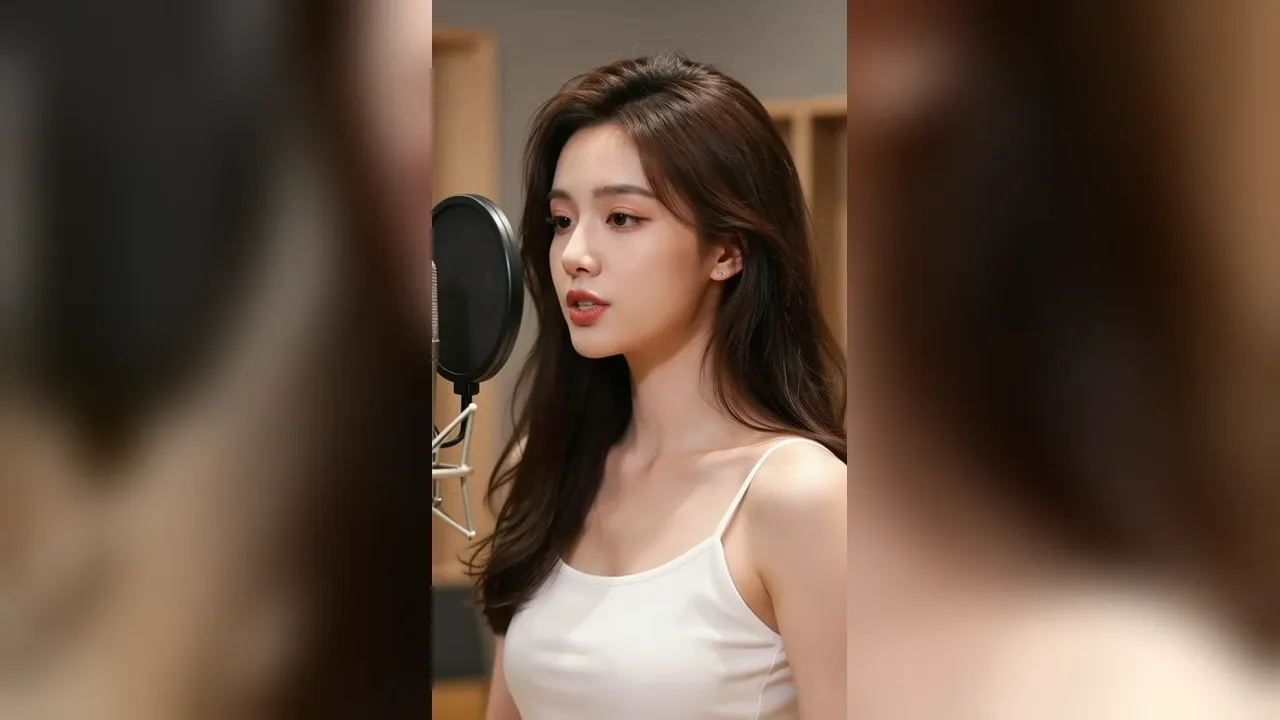
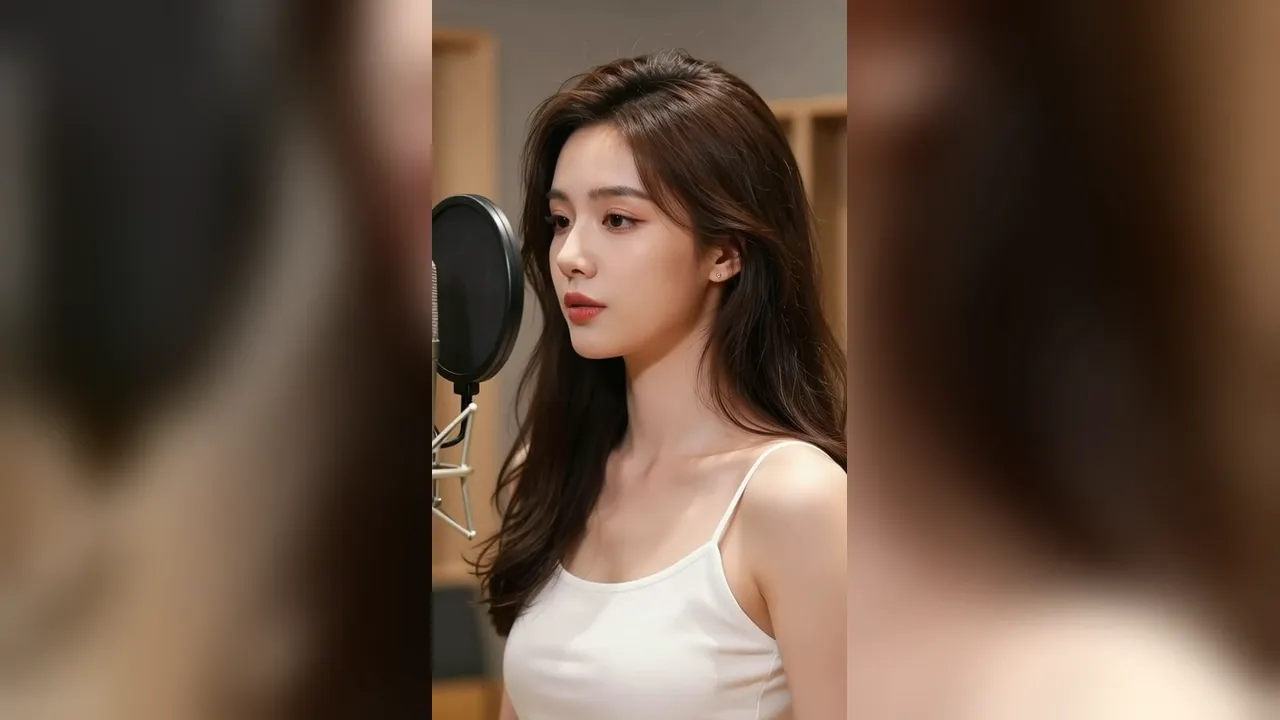
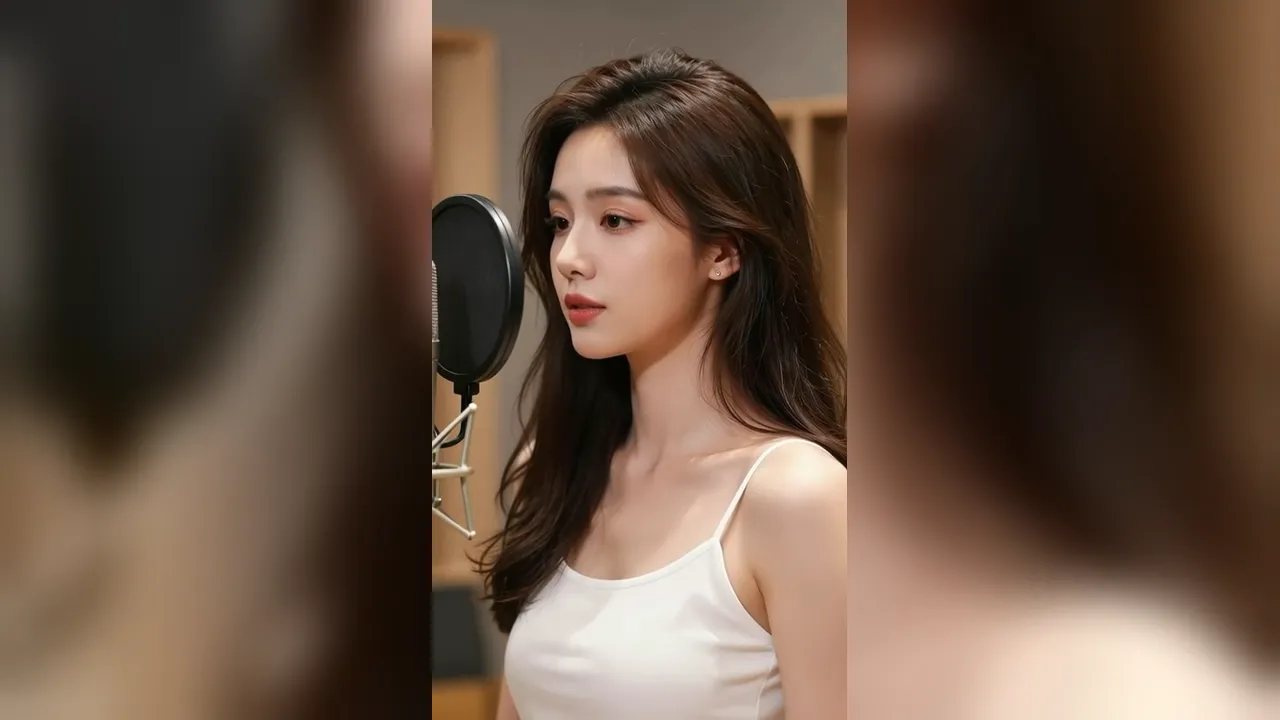
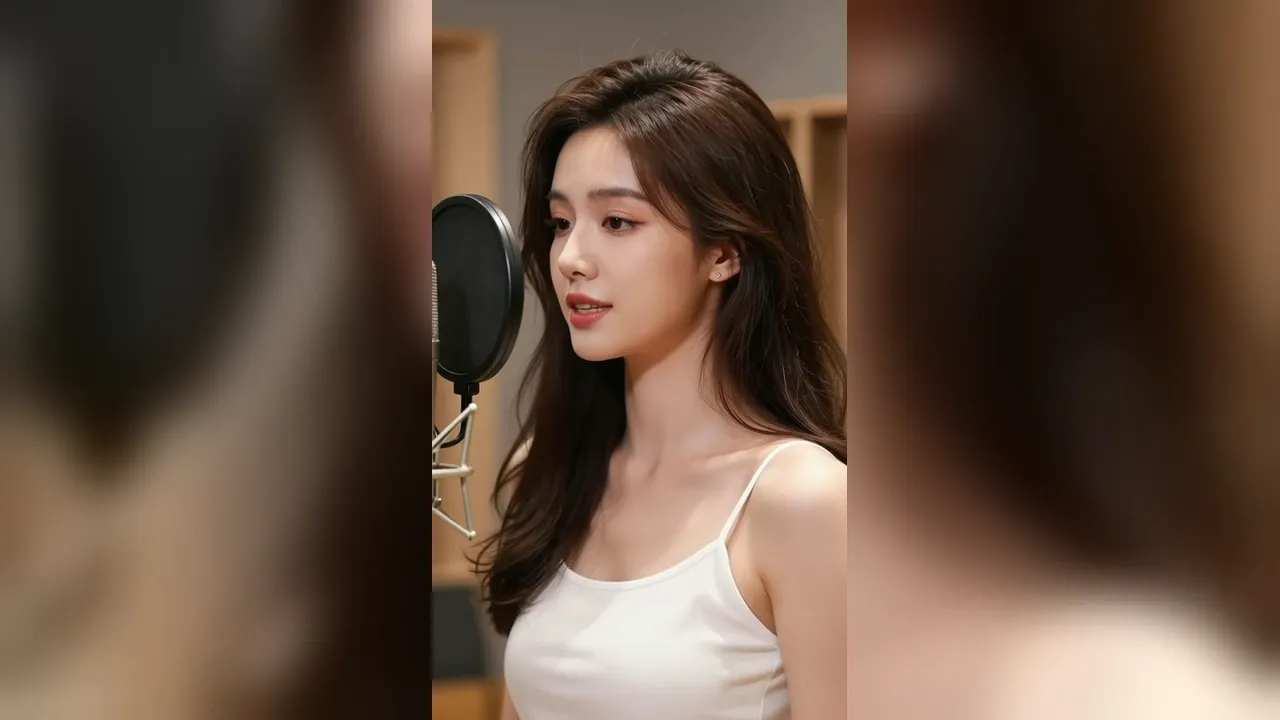
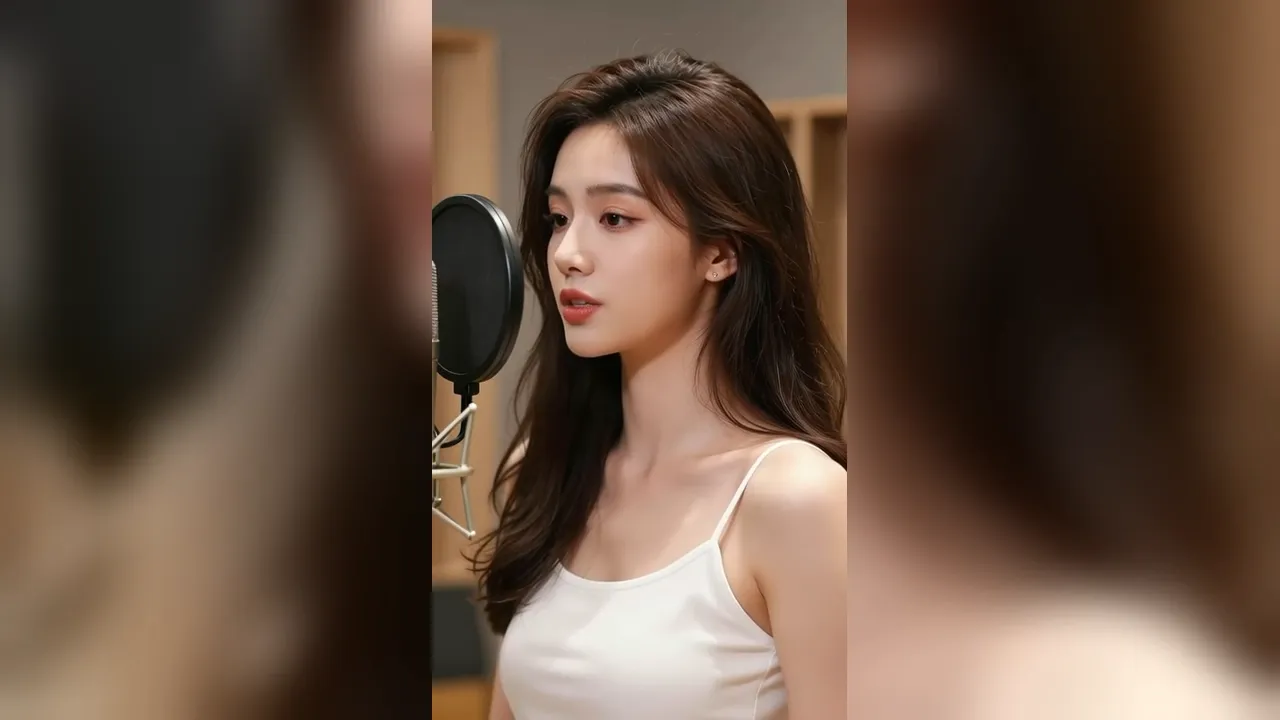
工作流说明
Wan2.2 S2V(Sound-to-Video)14B:一张人物图 + 一段音频 → 数字人对口型/对动作的视频。基于 WanVideoWrapper,三大块:
- 图片上传:人物图(示例 录音棚美女.png)→ 图像缩放v2(lanczos,832×480,crop 居中,被 16 整除)
- 模型加载:wan2.2_s2v_14B_bf16.safetensors 主模型 + lightx2v_T2V_14B_cfg_step_disti… LoRA(强度 1.0)+ wan_2.1_vae + Torch 编译设置(inductor)+ 块交换(要交换的块 40)
- 音频上传/音频处理:加载音频(示例 泡沫部分音频.MP3)→ Mel-Band RoFormer 人声/伴奏分离(MelBandRoformer_fp16.safetensors)→ 调整音频响度(KJ)(LUFS -23.0)→ 音频编码器编码(wav2vec2_large_english_fp16.safetensors)→ Wan视频添加S2V嵌入组(KJ)
- 采样:Wan视频空嵌入 → Wan视频采样器(CFG 1.00,lcm 调度器,Shift 4.00,帧窗口 81,音频缩放 1.0,总 161 帧)→ Wan视频解码(X/Y 分块 272 / 步长 144/128)→ VHS 合并(480×832,16fps,h264-mp4 crf19,前缀 WanVideo2_2_S2V)
下载渠道:HuggingFace 搜索 Wan2.2-S2V(官方 Repackaged)与 Mel-Band-RoFormer(KJNodes 支持自动下载)。
节点结构
节点结构截图待补充
运行环境与硬件要求
主模型s2v 14B bf16 —— 未量化,权重约 27GB 级(估算),必须依赖 offload/ 块交换
帧窗口机制81 帧窗口循环推进到 161 帧,长音频会持续滚窗,显存平稳但耗时长
音频链RoFormer 分离 + wav2vec2 编码都是轻量模型
最低显存12 GB
需要下载的模型
| 文件 | 类型 | 大小 | 放置目录 | 下载 |
|---|---|---|---|---|
wan2.2_s2v_14B_bf16.safetensors | 主模型(S2V) | models/diffusion_models | ||
lightx2v_T2V_14B_cfg_step_disti… | 加速 LoRA (强度 1.0000) | models/loras | ||
umt5-xxl-enc-fp8_e4m3fn.safetensors | T5 文本编码器 | models/text_encoders | ||
wan_2.1_vae.safetensors | VAE | models/vae | ||
MelBandRoformer_fp16.safetensors | 人声 / 伴奏分离模型 | | ||
wav2vec2_large_english_fp16.safetensors | 音频特征编码器 | |
需要安装的自定义节点
| 节点包 | 用途 | 安装方式 |
|---|---|---|
| ComfyUI-WanVideoWrapper(kijai) | Wan 视频模型加载器、设置 LoRA 、 Torch 编译设置、设置块交换、 VAE 加载器、文本编码 (缓存) 、空嵌入、音频编码器编码、添加 S2V 嵌入组 (KJ) 、采样器、解码 | ComfyUI-Manager 搜索安装 |
| MelBandRoFormer | 音频编码器加载、音频分离采样 | ComfyUI-Manager 搜索安装 |
| ComfyUI-KJNodes | 调整音频响度、图像缩放 v2 、 Set/Get | ComfyUI-Manager 搜索安装 |
| X AudioCrop | 音频裁切(comfyui-various 系) | ComfyUI-Manager 搜索安装 |
| Easy-Use / VideoHelperSuite | 清理 GPU 占用 / 合并为视频 | ComfyUI-Manager 搜索安装 |
使用步骤
- 上传人物图(单人大半身/全身,光线均匀)
- 上传音频(唱歌或说话)
RoFormer 自动分出人声,驱动口型的是人声轨。
- 写提示词 + 中文负面清单
- Queue
音频处理 → 滚窗采样(161 帧 ≈ 10 秒 @16fps)→ 合并 mp4(带原音频)。
关键参数说明
| 参数 | 所在节点 | 设置 | 说明 |
|---|---|---|---|
| 分辨率 | 480 × 832 (竖屏) | 数字人常用竖屏比例 | |
| 总帧数 | 161 | ≈10 秒 @16fps | |
| 帧窗口大小 | 81 | 滚窗长度,越长一致性越好、越吃显存 | |
| 音频缩放 | 1.0 | 口型 - 音频幅度映射 | |
| 响度 | LUFS -23.0 | 响度归一化目标 | |
| CFG | 1.00 | ||
| 调度器 | lcm | 配合 lightx2v 蒸馏 | |
| Shift | 4.00 | ||
| 块交换 | 要交换的块 40 | bf16 大模型省显存的核心开关 | |
| X/Y 分块 | 272 / 步长 144/128 | 解码分块 | |
| FETA / SLG / FlowEdit / FreeInit | 工作流采样器区可见(启用状态以工作流为准) | 采样增强选项 |
常见问题与报错
口型对不上
优先检查是否用了分离后的人声轨驱动(伴奏会严重干扰);音频缩放 过低会让口型幅度不足。
长音频中途崩
滚窗推进靠上下文衔接,帧窗口大小 81 别低于默认;启用帧打包 false 保持默认。
OOM
bf16 主模型最吃显存,确认块交换(40 块)生效;再不够换 fp8 版主模型。
人物变化大
S2V 身份保持依赖输入图质量与提示词中的外观描述,描述与图一致能显著稳住。
更新记录
- S2V v1Wan2.2 S2V + RoFormer 人声分离